简体中文

    MediaTek
    数据中心解决方案

    超越 XPU:革新 AI 规模化扩展的网络架构

    为何选择 MediaTek 布局数据中心?

    深入了解如何优化制程红利以提升性能功耗比(Perf/Watt)

    Early node adoption s

    采用先进制程

    MediaTek 处于制程技术的前沿,已在 N3 制程上完成超过 10 次流片,在 N2 制程上完成超过 2 次流片,A14 测试芯片也将于今年流片。

    我们以移动业务为先导——凭借庞大的出货量和规模优势来优化良率与设计工艺协同优化(DTCO),并迅速将这些经验应用于大规模数据中心芯片的设计中。这一模式使我们能够更快地将数据中心芯片推进至先进制程节点。

    Design Technology Co Optimization (DTCO) s

    设计-工艺协同优化(DTCO)

    通过 DTCO,我们与晶圆厂在先进(SOTA)制程节点上展开直接合作,对制程工艺进行微调,并定制、优化晶体管。

    通过 DTCO,我们与晶圆厂在先进(SOTA)制程节点上展开直接合作,对制程工艺进行微调,并定制、优化晶体管。——充分挖掘硅片所能提供的每一分性能。

    无论您是在架构单一 ASIC 还是全异构的 XPU,我们都能助力客户充分释放制程的全部潜能,并将其转化为决定性的竞争优势。

    Compute Efficiency Through Lower Voltage Operation

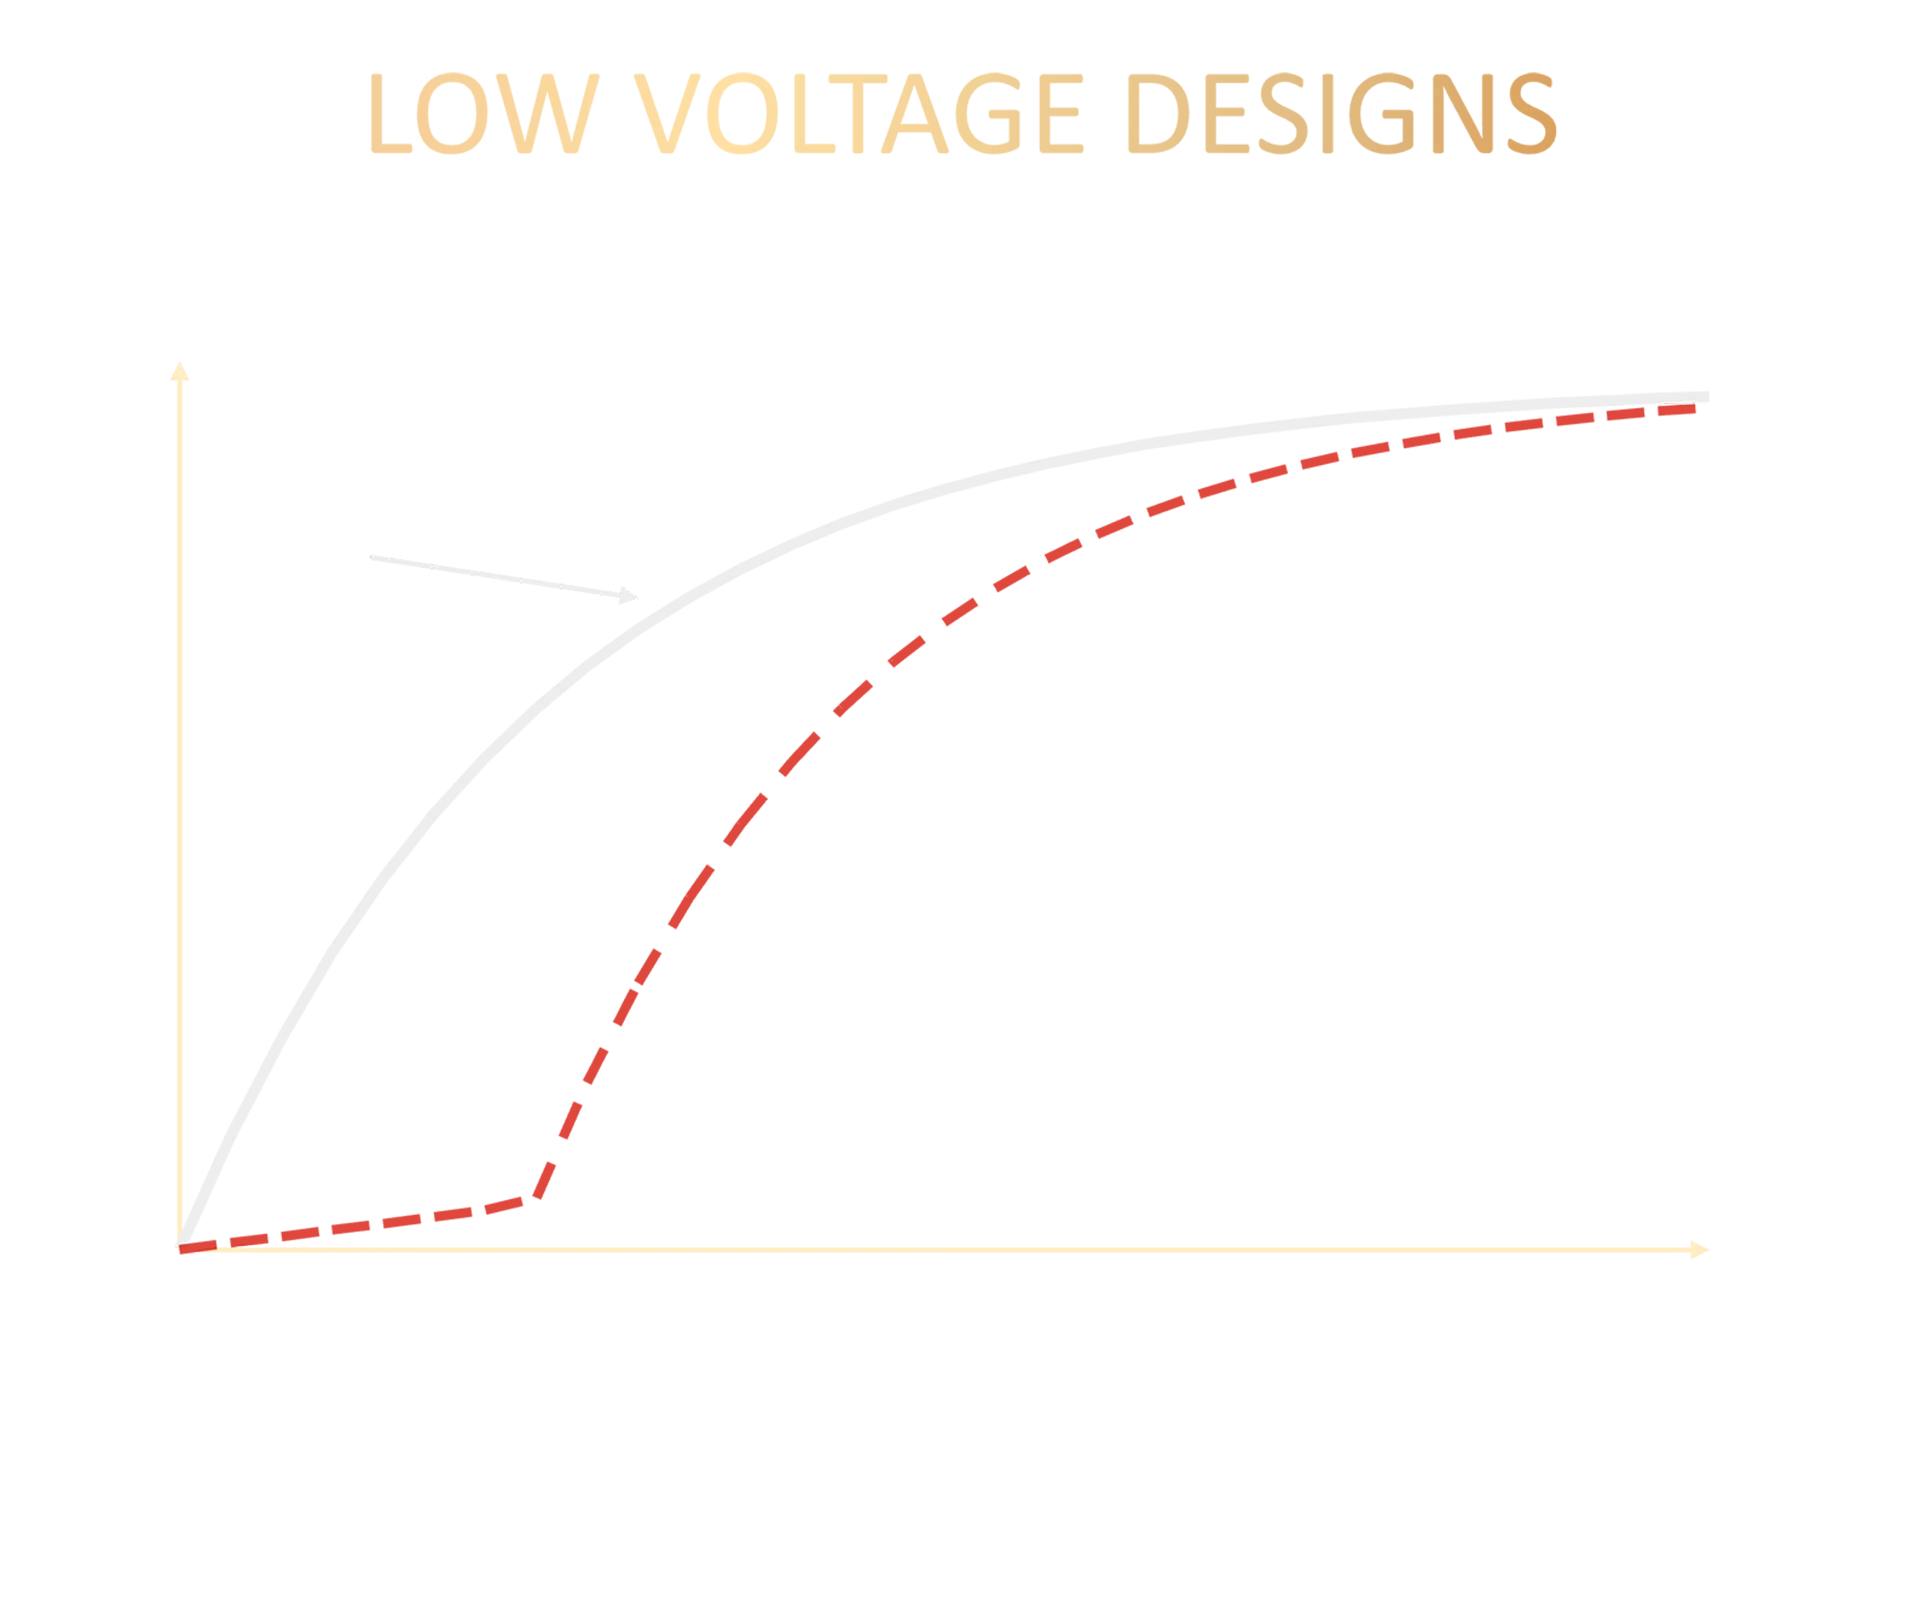
    通过低电压运行提升计算效率

    MediaTek 丰富的移动领域经验,使我们在将这些经验应用于数据中心芯片时具备显著的先发优势。

    提升计算效率有效的方式,就是让芯片在较低电压下运行。由于功耗与电压呈三次方关系,降低电压所带来的影响会被显著放大——在当今数据中心功耗预算受限的前提下,这一点至关重要。真正的挑战并非单纯降低运行电压,而是要移动性能曲线的拐点,确保降压时性能不会呈非线性骤降。这需要在设计、制程工艺和电路架构层面进行深度协同优化。MediaTek 丰富的移动领域经验——低电压运行正是立身之本——使我们在将这些经验应用于数据中心芯片方面占据显著的先发优势。

    打造 XPU 的核心组件

    每一颗 XPU 都始于同一个步骤:从晶圆开始,并进行极其精密的切割。晶圆切割(die singulation)会将整片晶圆分割成数百颗相同的晶粒,而这些晶粒正是组装成完整芯片的基本单元。

    每一个 AI 数据中心,都从这里开始

    定制 ASIC——由 MediaTek 设计

    多种晶圆,各自承担不同功能

    AI 计算、存储接口及互连技术,从单片晶圆上的功能单元,到完整的数据中心解决方案

    晶圆切割

    适用于先进封装的定制 ASIC 晶粒

    计算晶粒

    专为 AI 时代打造,并针对特定应用进行设计与优化

    先进封装。计算。存储。I/O。

    整合为一个统一的 AI 算力引擎,为高带宽而生,为规模化而生。

    先进封装

    封装已不再是设计的最后一步。要满足当今 AI 系统对性能与能效的要求,先进封装本身就是关键。

    芯片与封装的协同设计,是现代 AI 系统架构不可或缺的一环。它让我们突破单芯片设计的限制,将异构组件整合为一个高度协同、统一运作的计算引擎。

    先进封装
    2.5D

    通过 2.5D 封装,我们能够将计算单元(compute tile)与 HBM 并排布置于各类硅中介层(silicon interposer)上,从而在单一封装中实现强大的计算性能。


    规格:硅片面积<10,000 平方毫米

    先进封装
    3.5D

    3.5D 与 3D 式集成技术引入了垂直晶粒堆叠及更为复杂的集成方式,缩短逻辑、存储与 I/O 之间的距离,降低数据传输成本。

    与此同时,异构集成已成为推动进步的关键方向。我们以纳米级精度,将 CPU、XPU、高带宽存储器、高速 I/O 芯粒,乃至电源与散热结构整合在一起。


    规格:10,000 至 20,000 平方毫米硅片面积

    XPU

    客户既可以让 MediaTek 从零开始为其架构设计计算需求,也可以提供自有的 AI 加速器/逻辑 IP 与微架构,由我们将其整合到一个协同工作的系统中。

    计算晶粒(Compute Die)

    旨在驱动下一代 AI 应用场景而设计,专用的计算晶粒能够提供大规模并行处理密度,以加速复杂的 AI 训练与大规模低延迟推理工作负载。

    存储接口晶粒

    我们专门设计的存储接口晶粒可连接 HBM 及其它先进存储技术,并能灵活满足不同的带宽、容量与延迟需求,从而针对不同 AI 模型与部署场景进行精准优化。

    内存

    内存在 AI 系统 BOM 中占据主要成本和功耗,使每单位 TCO 的性能成为棘手的挑战。实现规模化需要在容量、带宽和成本之间取得平衡,同时应对供应链的实际限制。MediaTek 将 Digital Compute-in-Memory(DCIM)技术用于边缘 NPU,直接在内存阵列中执行计算,降低带宽瓶颈。

    5A HBF, SRAM, LPDDR GDDR, CNM CIM, HBM

    超高速 I/O

    我们整合超高速 I/O 与互连芯粒,并采用共封装铜互连(CPC)等创新技术,为短距离、高带宽通道提供高效连接。

    针对长距离连接,光引擎(OE)代表下一阶段的技术前沿,并推动向共封装光学(CPO)演进。光引擎既可采用标准封装技术进行整合,也可结合先进的中介层方案,以进一步提升集成密度。

    系统-技术协同优化(STCO)

    在设计-工艺协同优化(DTCO)的基础上,还需要系统-技术协同优化(STCO)才能实现芯片设计的全面优化。借助 CoWoS 级与 EMIB 级等先进平台,实现性能、密度、功耗与成本之间的平衡。

    MediaTek XPU
    Comptue Die Memory Interface Die Memory Ultra high speed IO System Technology Co Optimization (STCO)

    XPU

    客户既可以让 MediaTek 从零开始为其架构设计计算需求,也可以提供自有的 AI 加速器/逻辑 IP 与微架构,由我们将其整合到一个协同工作的系统中。

    计算晶粒(Compute Die)
    存储接口晶粒
    内存
    超高速 I/O
    系统-技术协同优化(STCO)
    Comptue Die
    Memory Interface Die
    Memory
    Ultra high speed IO
    System Technology Co Optimization (STCO)

    旨在驱动下一代 AI 应用场景而设计,专用的计算晶粒能够提供大规模并行处理密度,以加速复杂的 AI 训练与大规模低延迟推理工作负载。

    我们专门设计的存储接口晶粒可连接 HBM 及其它先进存储技术,并能灵活满足不同的带宽、容量与延迟需求,从而针对不同 AI 模型与部署场景进行精准优化。

    内存在 AI 系统 BOM 中占据主要成本和功耗,使每单位 TCO 的性能成为棘手的挑战。实现规模化需要在容量、带宽和成本之间取得平衡,同时应对供应链的实际限制。MediaTek 将 Digital Compute-in-Memory(DCIM)技术用于边缘 NPU,直接在内存阵列中执行计算,降低带宽瓶颈。

    5A HBF, SRAM, LPDDR GDDR, CNM CIM, HBM

    我们整合超高速 I/O 与互连芯粒,并采用共封装铜互连(CPC)等创新技术,为短距离、高带宽通道提供高效连接。

    针对长距离连接,光引擎(OE)代表下一阶段的技术前沿,并推动向共封装光学(CPO)演进。光引擎既可采用标准封装技术进行整合,也可结合先进的中介层方案,以进一步提升集成密度。

    在设计-工艺协同优化(DTCO)的基础上,还需要系统-技术协同优化(STCO)才能实现芯片设计的全面优化。借助 CoWoS 级与 EMIB 级等先进平台,实现性能、密度、功耗与成本之间的平衡。

    互连技术

    MediaTek 提供完整层级的专有互连解决方案——从封装内晶粒间互连(UCIe、MLink),到板上芯片间连接(SerDes/PCIe、uLED),再到长距离电/光链路(SerDes/以太网、NPC/CPC、CPO)——每一层级均针对传输距离、单位 TCO 性能与单位功耗性能进行调优。这些方案充分考虑机架与系统整体需求,实现的是可扩展的定制化性能,而非通用商品。

    封装内(ON PACKAGE)

    晶粒间互连

    技术

    UCIe
    MLink

    板级(ON BOARD)

    芯片间互连

    技术

    高速 SerDes(PCIe)
    uLED

    板外互连(OFF BOARD)

    板间互连

    技术

    高速 SerDes(以太网)
    NVLink Fusion
    NPC/CPC 连接器
    共封装光学(Co-Package Optics)

    光互连

    传输距离可达 500 米

    数据中心的核心构建组件

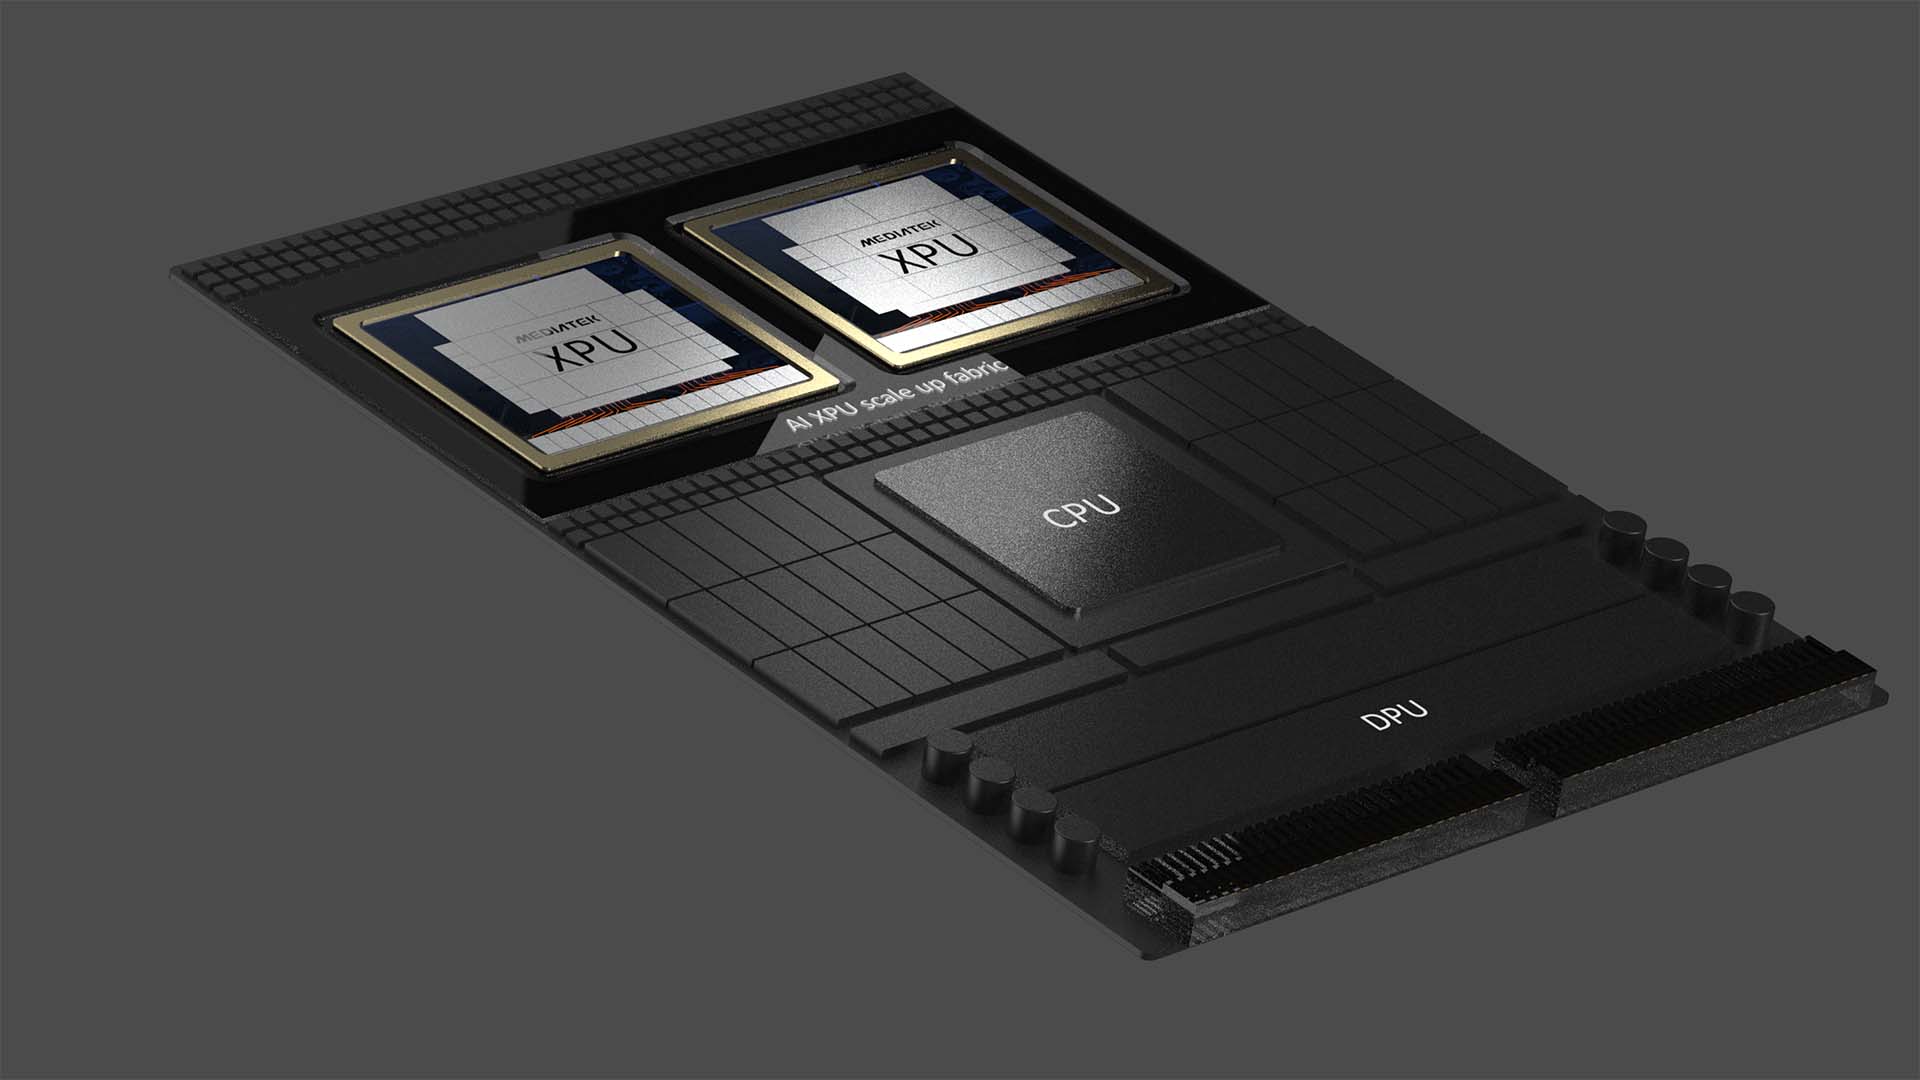
    AI 计算系统

    围绕三大支柱进行协同优化:计算、纵向扩展(Scale-up)互连与横向扩展(Scale-out)互连。

    支持业界标准互连方案(UALink、UEC)以及专有互连方案(NVLink)。

    通过异构集成,支持新的系统应用场景,并提升性能/TCO 表现。
    AI Compute System

    机架(The Rack)

    新的计算消费单元。

    通过面向云端 AI 与企业客户的软硬件垂直整合,创造更高价值。

    功耗、散热与可靠性决定了性能表现。

    要实现有效的商业变现,需要针对不同使用场景对机架进行优化。

    单位 TCO 性能与单位功耗性能是实现数据中心能效的关键指标。

    The Rack

    与 MediaTek 合作

    NVIDIA NVLink Fusion

    作为 NVLink Fusion 生态系统的关键参与者,MediaTek 以完整的机架级解决方案,帮助客户加快产品上市进程。通过 NVLink C2C 将定制 XPU 无缝连接至 NVIDIA 生态系统,我们的架构从机架级 ASIC 计算托盘与 NVSwitch 托盘延伸,并可进一步通过 InfiniBand 与 Ethernet 实现横向扩展。凭借与 NVIDIA 的强大合作伙伴关系,我们提供从端到端的完整全栈数据中心解决方案,这一创新方案已引起客户的浓厚兴趣。

    NVIDIA NVLink Fusion

    新一代有源光缆(AOC)

    新一代有源光缆(AOC),采用 MicroLED 光源与 MOSAIC 架构。

    MediaTek 与微软的概念验证成果展示:

    • 显著节能
    • 延长 AI 集群的传输距离
    • 媲美铜缆的可靠性
    • 更强的可扩展性

    我们致力于进一步实现小型化,并为吉瓦级 AI 数据中心做好量产准备

    了解我们的合作伙伴关系
    Microsoft

    常见问题(FAQ)

    什么是 XPU?它与 CPU 或 GPU 有何不同?

    XPU 是一类专为应对大型 AI 模型训练与推理所需的大规模并行计算需求而设计的 AI 加速器。与专为通用串行任务优化的 CPU、或最初为图形处理而设计的 GPU 不同,XPU 从设计之初就专为 AI 工作负载而生——旨在优化张量运算、矩阵运算与稀疏计算的吞吐量。在现代 AI 数据中心中,XPU 处于 AI 计算系统的核心位置,与 CPU、DPU 共同构成异构架构,由每种处理器负责其运行效率高的 AI 生命周期阶段。MediaTek 设计的定制 XPU,将先进封装、高带宽存储器(HBM)与互连技术作为一个统一系统进行协同优化。

    什么是面向 AI 的定制 ASIC?超大规模云服务商为何要自行打造这类芯片?

    面向 AI 的定制 ASIC(专用集成电路)是一种从零开始设计的芯片,专门匹配特定企业的模型架构、工作负载特征与基础设施限制条件,而非依赖现成的通用芯片。超大规模云服务商与云服务提供商打造定制 ASIC,是为了掌握架构主导权、优化单位功耗性能与单位 TCO 性能,并避免通用硬件带来的低效问题。MediaTek 与这些客户展开端到端合作,共同架构设计定制 ASIC 与 XPU:从逻辑晶粒设计、存储接口架构,到先进的 2.5D/3.5D 封装与机架级整合,全流程覆盖。最终成果是一套专为特定工作负载打造的计算引擎,在真正重要的指标——大规模场景下的单位功耗 Token 数与单位成本 Token 数——上超越通用商品化方案。

    什么是 AI 计算系统?它包含哪些组成部分?

    AI 计算系统是训练大型 AI 模型并大规模运行高吞吐量 AI 推理所需的完整硬件堆栈——其范畴远超单一芯片。其核心是 XPU(AI 加速器),但围绕它还有一整套完整架构:异构计算(针对不同工作负载阶段调优的 CPU、DPU 与 XPU)、纵向扩展互连(保持高带宽、低单比特能耗的封装内晶粒间互连),以及横向扩展互连(为带宽、传输距离与效率而打造的机柜级与数据中心级架构)。存储器——HBM、cHBM、LPDDR、SRAM——与计算单元共同封装,以降低数据搬移所消耗的能量。先进封装(2.5D、3.5D、晶圆级)将这些异构组件整合为一个协同运作的整体。MediaTek 设计的 AI 计算系统对每一环节都进行协同优化,使机柜成为一项战略资产,而非零部件的简单堆砌。

    什么是共封装光学(CPO)?它为何对 AI 数据中心至关重要?

    共封装光学(CPO)是一种将光引擎直接整合进芯片封装内的技术——通常与计算裸片、高带宽存储器共用同一硅中介层或基板,而非将光收发模块置于独立的线卡上。在 AI 数据中心中,横向扩展网络必须以低延迟、低功耗在机柜与机柜排之间传输海量数据,相较于传统可插拔光模块,共封装光学能够大幅降低单比特能耗与信号损耗。随着 AI 集群规模从数百个 XPU 扩展至数万个 XPU,互连功耗与带宽密度已成为首要制约因素,而 CPO 正逐渐成为主流解决方案。MediaTek 会根据每位客户的 I/O 与系统级连接需求,采用基于中介层或标准封装的方式,将共封装光学整合进其 AI 计算系统设计中。

    先进封装(2.5D/3.5D)如何提升 AI 芯片性能?

    先进封装——包括 2.5D 与 3.5D 整合技术——使 AI 芯片设计者能够突破单一裸片的物理限制,将多个芯粒(计算晶粒、存储接口晶粒、HBM 堆叠、SerDes、光引擎)整合进一个如同统一系统般运作的封装中。在 2.5D 封装中,各组件并排布置于硅中介层上,在封装内部实现很高的存储带宽。3.5D 与 3D 整合则加入了垂直堆叠,使逻辑与存储之间的耦合更加紧密,从而降低延迟与功耗。对 AI 工作负载而言,这一点至关重要:存储带宽往往是主要瓶颈,而先进封装能够实现单片裸片无法企及的带宽密度。MediaTek 在其 AI 计算系统中全面应用设计-技术协同优化(DTCO)与系统-技术协同优化(STCO),目标是将系统级单位功耗性能提升 100 倍,并将等效光罩系统尺寸有效提升 40 倍。

    AI 模型训练与 AI 推理有何区别?数据中心如何同时支持这两者?

    AI 模型训练是在海量数据集上训练大型语言模型或多模态模型的高计算密集型过程——它对存储带宽、持续高吞吐量以及长时间作业的容忍度都有极高要求。AI 推理则是将训练完成的模型部署投入使用,以大规模提供实时预测、决策或生成式输出——它更看重低延迟、高并发与能效表现。现代 AI 数据中心会同时运行这两种工作负载,通常针对各阶段采用不同的优化硬件。XPU 专为训练所需的高吞吐量而调优;DPU 负责网络与存储卸载管理;CPU 则处理编排与控制平面任务。MediaTek 设计的异构 AI 计算系统,针对训练与推理两个场景对存储层级架构、互连与封装进行协同优化,并针对推理中的预填充(prefill)与解码(decode)阶段采用差异化架构设计。

    「每瓦 Token 数」(tokens per watt)是什么意思?它为何取代 TOPS 成为 AI 芯片的关键指标?

    TOPS(每秒万亿次运算)衡量的是理论峰值吞吐量,但它忽略了功耗、存储带宽限制以及实际工作负载效率——因此难以准确反映 AI 数据中心的真实运营经济性。每瓦 Token 数衡量的是系统每消耗一瓦功率所能产出的有效 AI 输出量(生成的 Token 数、提供的预测结果数),这一指标与运营成本及机房容量直接挂钩。随着全球数据中心功耗持续攀升、超大规模云服务商逐渐触及电网供电上限,每瓦 Token 数已成为评估 AI 加速器与定制 ASIC 的核心基准指标。MediaTek 在其定制 XPU 与 AI 计算系统设计中,始终将能耗视为首要设计约束——从低电压电路设计、存内计算架构,到共封装光学与系统级供电方案——力求在机柜层级实现每瓦 Token 数的优化。

    高带宽存储器(HBM)在 AI 加速器与定制 ASIC 中扮演什么角色?

    高带宽存储器(HBM)是与 AI 加速器及定制 ASIC 共同封装的堆叠式 DRAM,用于提供大型 AI 模型训练与推理所需的极高存储带宽。随着模型规模从数十亿参数增长至数万亿参数,「存储墙」——即计算吞吐量与存储带宽之间的差距——已成为 AI 系统中的主要性能瓶颈。HBM 通过先进的 2。5D/3D 封装技术,将宽接口存储裸片直接置于计算裸片之上或旁侧,从而在单一封装内实现每秒数太字节的带宽。MediaTek 设计专用的存储接口晶粒,将计算晶粒与 HBM 及其他存储技术(cHBM、LPDDR、SRAM)相连,并针对每一类工作负载对带宽、容量与延迟进行协同优化。展望未来,诸如 HBF(高带宽闪存)等新兴技术正在研发中,以支持前所未有的存储容量,实现大规模推理。

    MediaTek 的端到端 AI 数据中心解决方案与购买通用现成 AI 芯片有何不同?

    现成的通用 AI 芯片属于通用型加速器,旨在服务众多客户、覆盖多样化的工作负载——它们是针对中等水平的通用使用场景进行优化的,而非专门针对您特定的模型架构、部署规模或基础设施限制。MediaTek 的端到端方案则意味着将定制 ASIC 或 XPU、先进封装(2.5D/3.5D)、存储层级架构、高速互连、共封装光学、供电方案与机柜整合,作为一套统一的 AI 计算系统进行协同设计——所有环节均针对客户特定的模型、功耗预算与 TCO 目标定制。这种垂直整合模式,使 MediaTek 客户相较于通用商品化方案,能够实现更优的单位 TCO 性能与单位功耗性能,同时掌握自有平台架构,从而获得长期竞争优势。MediaTek 与正在就如何大规模训练与部署模型进行长期布局的超大规模云服务商、云服务提供商及 AI 平台企业展开合作。

    什么是面向 AI 基础设施的定制芯片?目前有哪些企业正在打造这类芯片?

    面向 AI 基础设施的定制芯片,是指专为特定企业自身 AI 工作负载而设计的芯片与系统,而非作为标准商用产品购入。其范畴涵盖定制 ASIC(专用集成电路)、定制 XPU(加速处理器)、存储接口裸片、SerDes 芯粒以及光学集成方案——所有这些均被整合架构为一套完整的 AI 计算系统。以谷歌、Meta、亚马逊、微软为代表的超大规模云服务商引起了这一趋势,他们打造定制芯片,以在相当于数百万颗 GPU 的算力规模下优化训练与推理。企业级云服务提供商及 AI 原生企业也正日益跟进。这一趋势背后的驱动力在于经济性:当针对特定模型类别与部署环境进行设计时,定制芯片相较于现成方案,能够实现 2 至 5 倍的单位功耗性能与单位 TCO 性能提升。MediaTek 与晶圆厂合作,端到端设计并交付定制芯片解决方案——涵盖逻辑晶粒架构、先进封装、互连与机架整合等全流程。