次世代のAIユースケースを支えるべく設計されたこの専用コンピュート・ダイは、複雑なAI学習や低遅延の推論ワークロードを大規模に高速化するために必要な、極めて高い並列処理密度を実現します。
プロセスの潜在能力を極限まで引き出す、圧倒的な電力効率(Perf/Watt)を実現
業界に先駆けた最先端プロセスの採用
MediaTekはプロセス技術の最前線に位置しており、N3で10件以上、N2で2件以上のテープアウト(設計完了・製造委託)実績を誇るほか、年内には初のA14テストチップのテープアウトも予定しています。
当社はモバイル分野を主導し、その圧倒的な生産規模とスケールメリットを活かして歩留まりの最適化やプロセス技術との協調最適化(DTCO)を推進しています。そして、そこで得られた知見を大規模データセンター向け設計へ迅速に展開しています。こうしたアプローチにより、当社は業界に先駆けて、データセンター向け製品への最先端ノードの適用を可能にしています。
DTCO(Design-Technology Co-Optimization:設計・技術協調最適化)
当社はDTCOを通じ、最先端のプロセスノードを有する大手ファウンドリと直接連携してプロセスの微調整を行い、トランジスタのカスタマイズや最適化を実施します。これにより、シリコンが持つ性能を極限まで引き出します。
単一のASICであれ、完全なヘテロジニアス構成のXPUであれ、お客様がプロセスの潜在能力を最大限に活用し、それを決定的な競争優位性へと変革できるよう支援します。
低電圧動作による演算効率の向上
MediaTek'sはモバイル分野で培った豊富な経験を活かし、データセンター向けチップへの技術応用において大きな優位性を有しています。
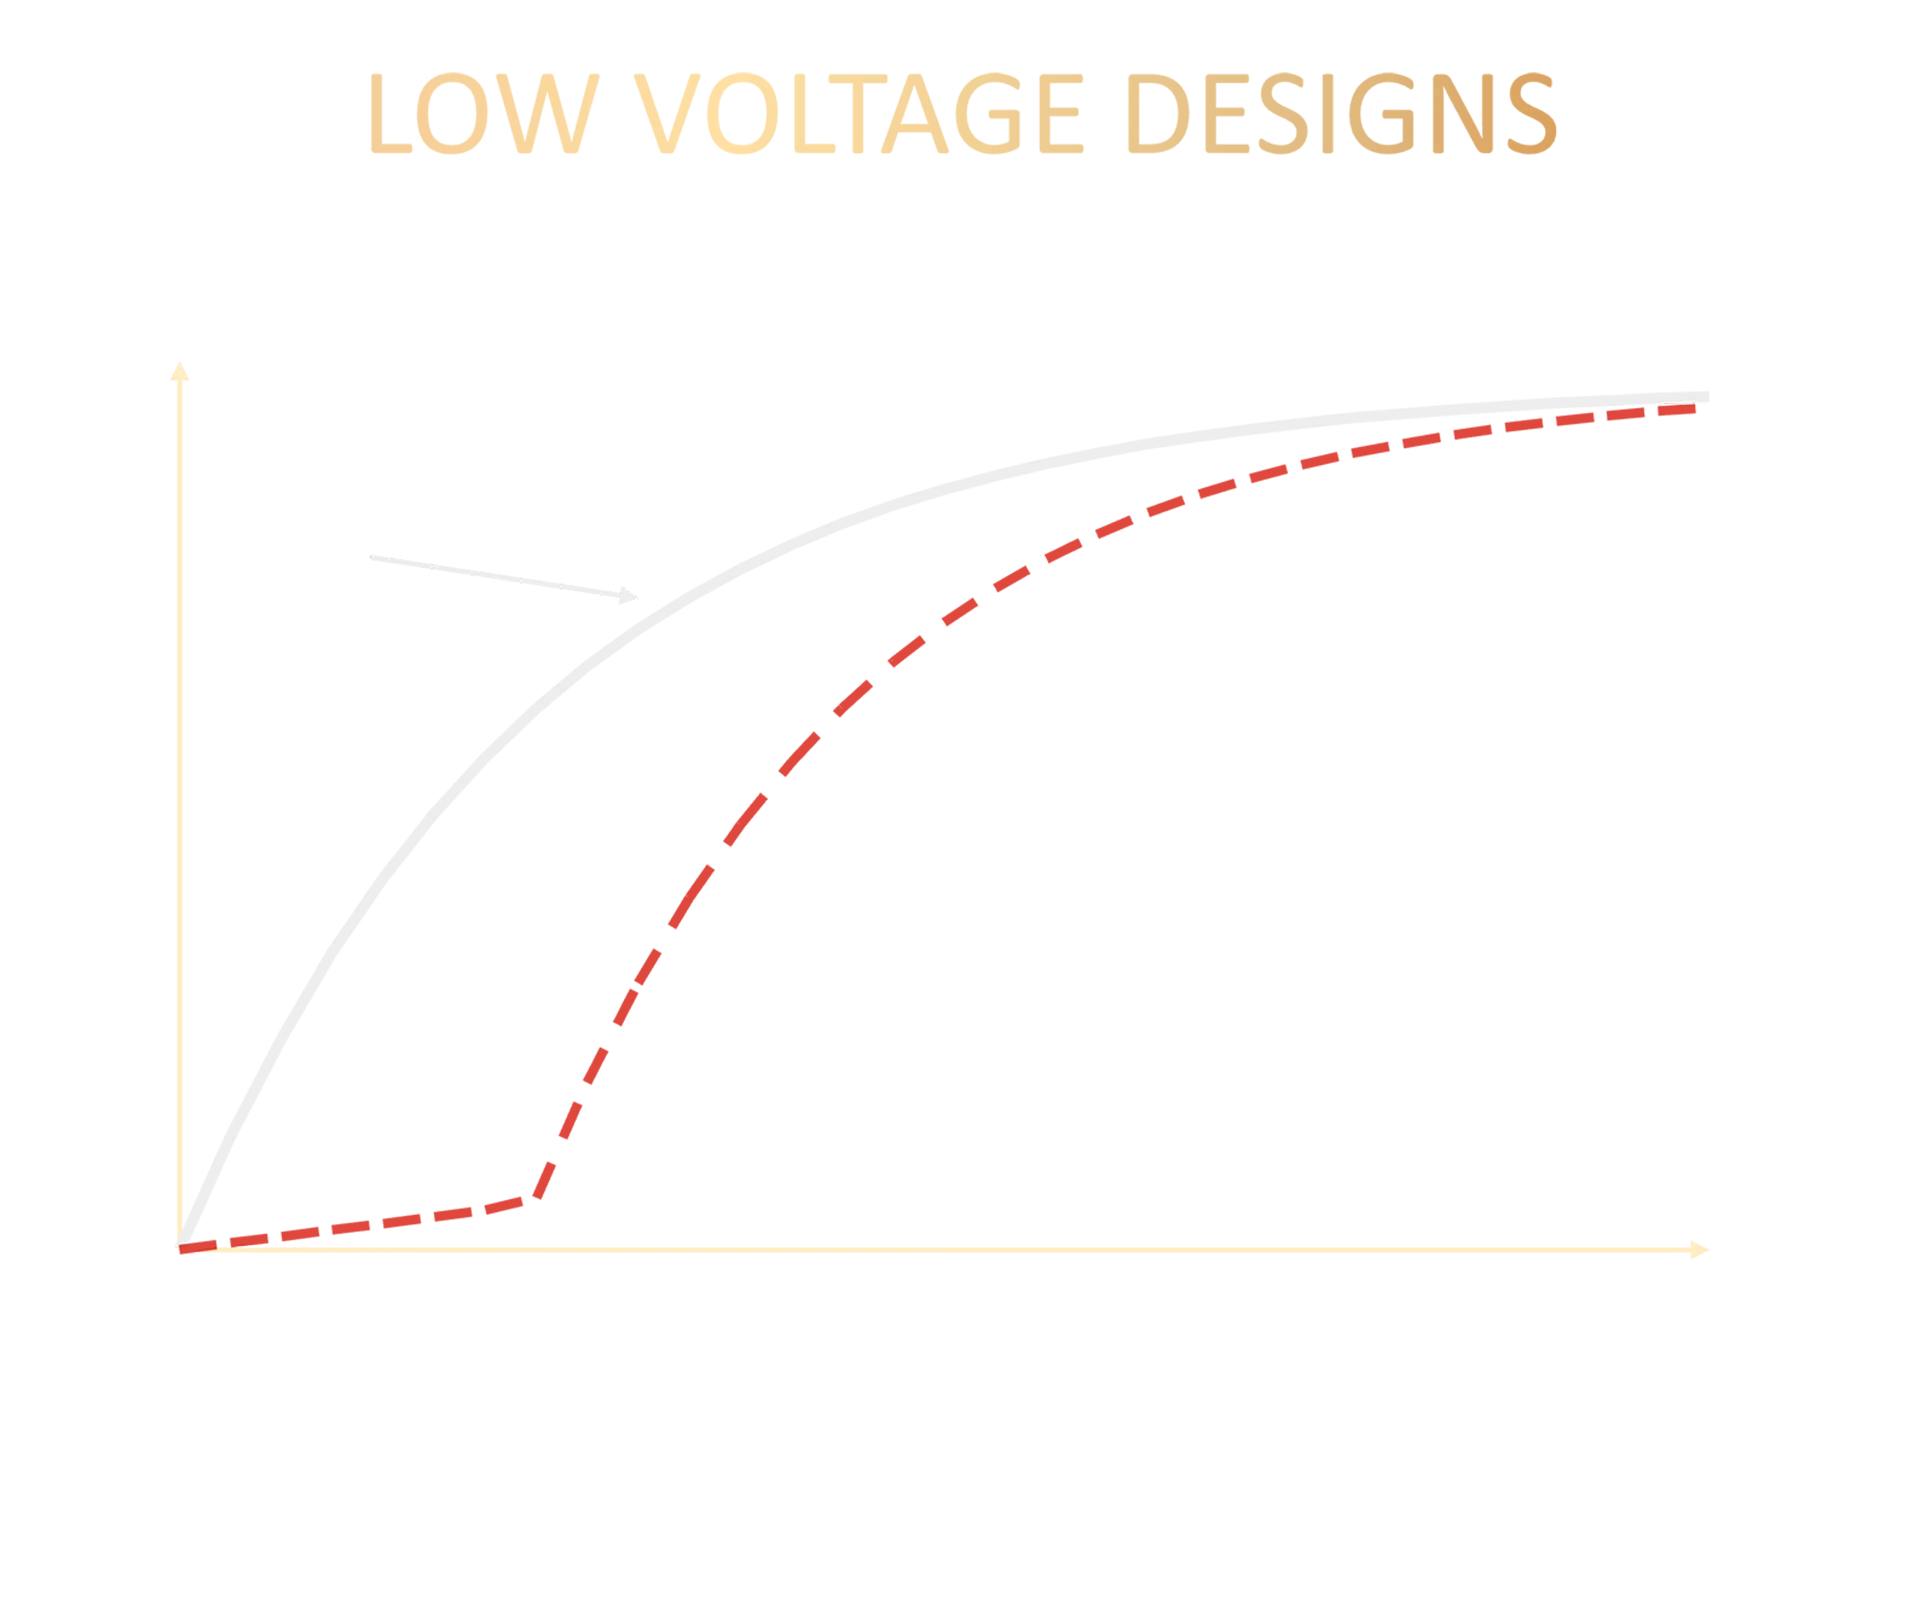
演算効率を高める上で最も効果的な手法は、チップを低電圧で動作させることです。消費電力は電圧の3乗に比例して変化するため、低電圧での動作は極めて大きな効果をもたらします。データセンターにおける電力供給量が厳格に制限されている今日、この点は極めて重要です。
真の課題は、単に低電圧で動作させることではなく、電圧を下げても性能が非線形に低下しないよう、特性曲線の「変曲点(ニーポイント)」を最適化することにあります。これには、設計、プロセス技術、回路アーキテクチャにわたる高度な協調最適化が不可欠です。
低電圧動作が技術の根幹を成すモバイル分野での豊富な経験こそが、データセンター向けチップへの技術応用において、MediaTekに大きな優位性をもたらしているのです。
XPUを構成する基本要素をつくる
すべてのXPUは、1枚のウェハーから極めて精密にダイを切り出すプロセスから始まります。ダイシングによって1枚のウェハーを数百個の同一ダイに分割し、それらが最終的に1つのチップを構成する基本単位となります。
あらゆるAIデータセンターは、ここから始まる
MediaTekが設計するカスタムASIC
複数のウェハー。それぞれ異なる役割
AIコンピュート、メモリ・インターフェース、インターコネクト。個々のウェハー上の機能から、データセンター・ソリューション全体へ
ダイ・シングレーション
先進パッケージングに対応したカスタムASICダイ
コンピュート・ダイ
AI時代に向けて専用設計・最適化されたコンピュート・ダイ
先進パッケージング、
コンピュート、メモリ、I/O。
1つの統合されたAIコンピュート・エンジンへ。広帯域を追求し、スケーリングを見据えて設計されています。
先進パッケージング
パッケージングは、もはや設計の後工程ではありません。今日のAIシステムが求める高性能と電力効率を実現するためには、パッケージングそのものが重要な設計要素だからです。
シリコンとパッケージの協調設計(co-design)は、現代のAIシステム・アーキテクチャにおいて不可欠です。これにより、単一ダイ設計の物理的な限界を超え、異なる機能を持つコンポーネントを1つの高密度で一体化されたコンピュート・エンジンへと統合できます。
先端パッケージング
2.5D
2.5Dパッケージングでは、各種シリコンインターポーザ上にコンピュート・タイルとHBMを並べて配置することで、単一のパッケージで極めて高い演算性能を実現します。
仕様:10,000sq.mm未満のシリコン
高度なパッケージング
3.5D
3.5Dおよび3Dスタイルの統合技術は、ダイ同士の垂直方向の積層やより複雑な統合を実現し、ロジック、メモリ、I/O間の距離を最小化することで、データ転送に伴うコストを削減します。
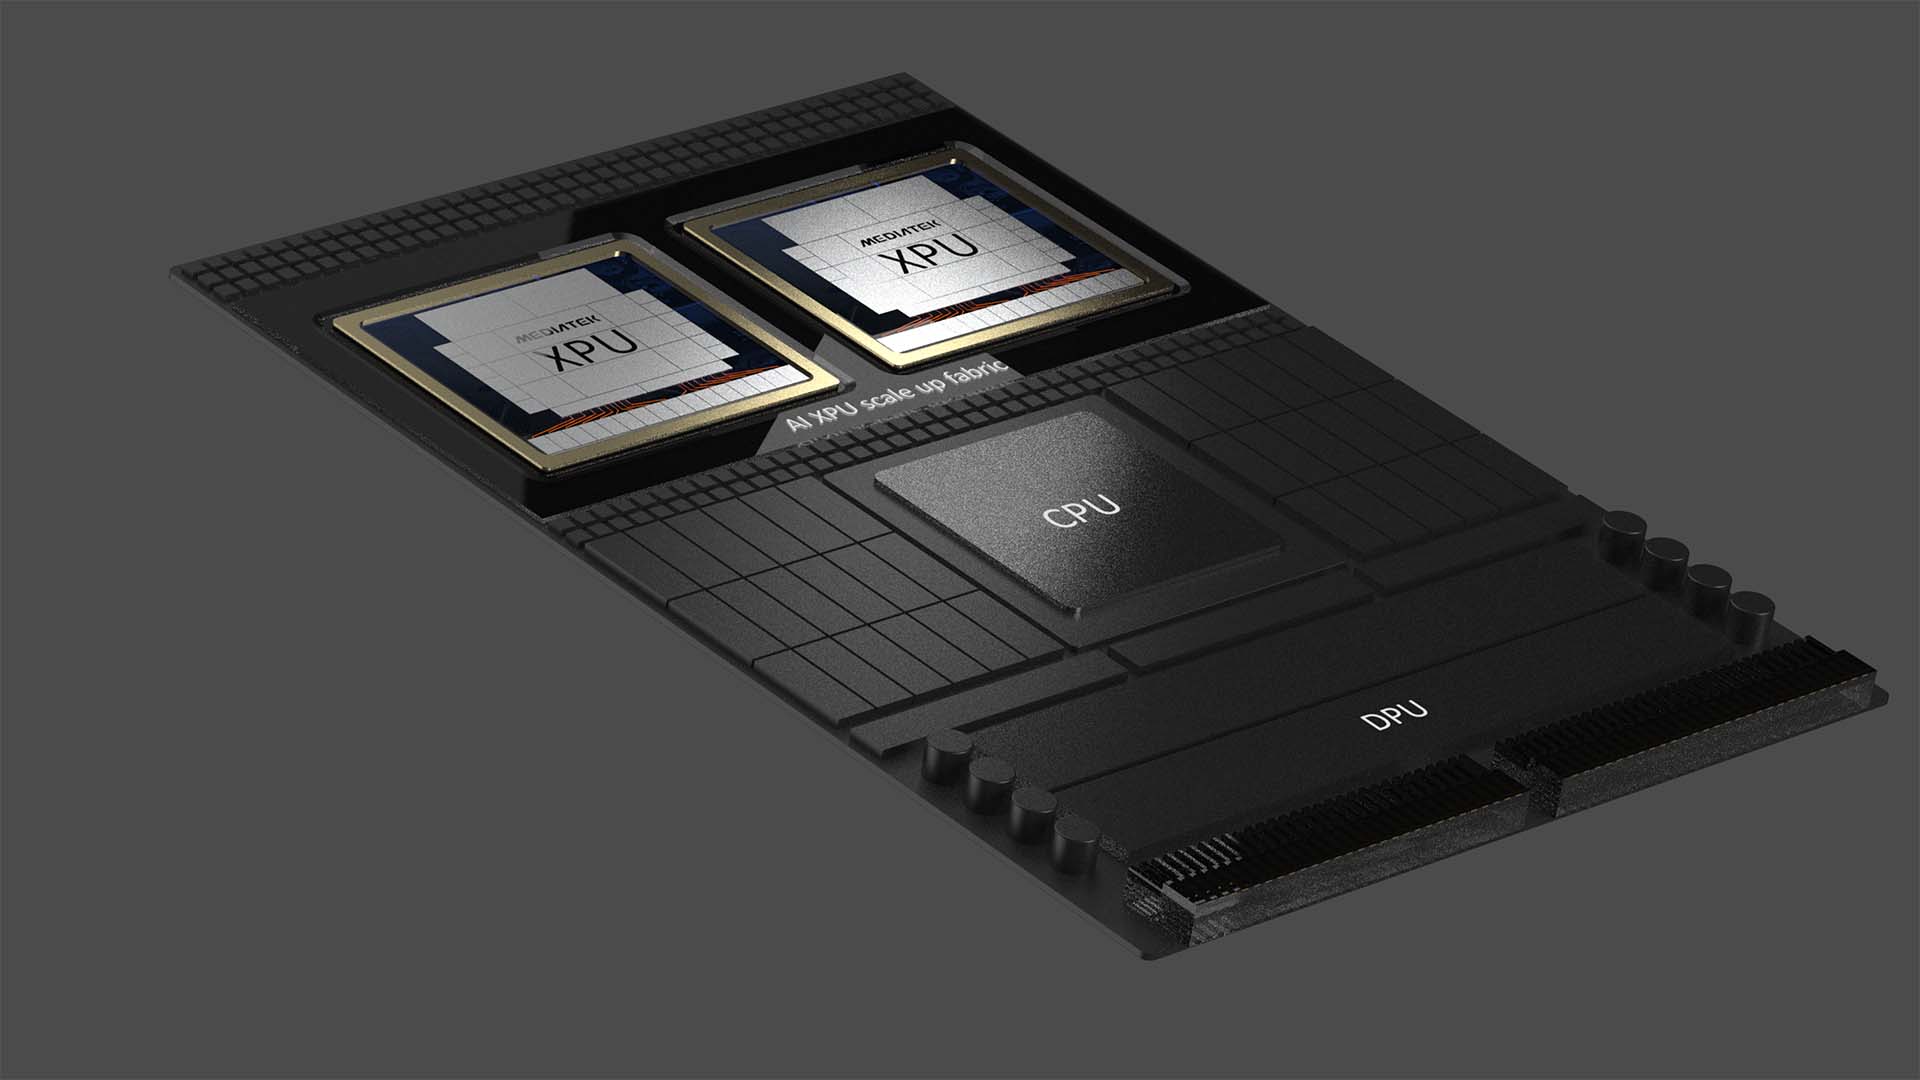
同時に、ヘテロジニアス・インテグレーション(異種機能統合)が技術進化の重要な鍵となっています。当社は、CPU、XPUs、広帯域メモリ、高速I/Oチップレット、さらには電力供給や熱管理の構造に至るまでを、ナノメートル単位の精度で統合しています。
仕様:シリコン面積 10,000~20,000 sq.mm Si
XPU
お客様は、演算要件に基づいたアーキテクチャ設計をゼロからMediaTekに委託することも、あるいは自社のAIアクセラレータ/ロジックIPやマイクロアーキテクチャを提供し、それらを高い相乗効果を発揮する1つのシステムへと統合することも可能です。
コンピュート・ダイ
次世代のAIユースケースを支えるべく設計されたこの専用コンピュート・ダイは、複雑なAI学習や低遅延の推論ワークロードを大規模に高速化するために必要な、極めて高い並列処理密度を実現します。
メモリ・インターフェース・ダイ
MediaTekの専用メモリ・インターフェース・ダイは、HBMをはじめとする先進メモリ技術と接続し、帯域幅、容量、レイテンシの要件に柔軟に対応します。これにより、AIモデルの種類や導入シナリオごとに、システムを極めて高精度に最適化できます。
メモリ
メモリはAIシステムのBOMコストと消費電力の大きな部分を占めるため、TCOに対する性能を最大化することが最大の課題となっています。システムを大規模化するには、供給網の現実的な制約も踏まえながら、容量、帯域幅、コストのバランスを取る必要があります。MediaTekは、エッジNPU向けにDigital Compute-in-Memory(DCIM)をいち早く導入し、メモリアレイ内で直接演算を行うことで、帯域幅のボトルネックを解消します。
超高速I/O
超高速I/Oとインターコネクト・チップレットを統合し、短距離・高帯域のチャネル向けにはコパッケージ・カッパー(CPC)などの革新技術を活用します。
長距離接続では、光エンジン(OE)が次の技術フロンティアとなり、コパッケージ・オプティクス(CPO)への移行を可能にします。光エンジンは、標準的なパッケージング技術だけでなく、先進のインターポーザ・ベースのアプローチにも対応し、さらなる高密度な統合を実現します。
システム・テクノロジ・コ・オプティミゼーション(STCO)
チップ設計を全面的に最適化するには、DTCO(設計・テクノロジ・コ・オプティミゼーション)を発展させたSTCO(システム・テクノロジ・コ・オプティミゼーション)が不可欠です。CoWoSクラスやEMIBクラスのソリューションといった高度なプラットフォームを活用し、性能、集積度、消費電力、コストの最適なバランスを実現します。
XPU
お客様は、演算要件に基づいたアーキテクチャ設計をゼロからMediaTekに委託することも、あるいは自社のAIアクセラレータ/ロジックIPやマイクロアーキテクチャを提供し、それらを高い相乗効果を発揮する1つのシステムへと統合することも可能です。
MediaTekの専用メモリ・インターフェース・ダイは、HBMをはじめとする先進メモリ技術と接続し、帯域幅、容量、レイテンシの要件に柔軟に対応します。これにより、AIモデルの種類や導入シナリオごとに、システムを極めて高精度に最適化できます。
メモリはAIシステムのBOMコストと消費電力の大きな部分を占めるため、TCOに対する性能を最大化することが最大の課題となっています。システムを大規模化するには、供給網の現実的な制約も踏まえながら、容量、帯域幅、コストのバランスを取る必要があります。MediaTekは、エッジNPU向けにDigital Compute-in-Memory(DCIM)をいち早く導入し、メモリアレイ内で直接演算を行うことで、帯域幅のボトルネックを解消します。
超高速I/Oとインターコネクト・チップレットを統合し、短距離・高帯域のチャネル向けにはコパッケージ・カッパー(CPC)などの革新技術を活用します。
長距離接続では、光エンジン(OE)が次の技術フロンティアとなり、コパッケージ・オプティクス(CPO)への移行を可能にします。光エンジンは、標準的なパッケージング技術だけでなく、先進のインターポーザ・ベースのアプローチにも対応し、さらなる高密度な統合を実現します。
チップ設計を全面的に最適化するには、DTCO(設計・テクノロジ・コ・オプティミゼーション)を発展させたSTCO(システム・テクノロジ・コ・オプティミゼーション)が不可欠です。CoWoSクラスやEMIBクラスのソリューションといった高度なプラットフォームを活用し、性能、集積度、消費電力、コストの最適なバランスを実現します。
最先端のインターコネクト技術
MediaTekは、独自のインターコネクト・ソリューションを包括的な階層構造で提供しています。その範囲は、オンパッケージのダイ間リンク(UCIe、MLink)やオンボードのチップ間接続(SerDes/PCIe、uLED)から、長距離の電気・光リンク(SerDes/Ethernet、NPC/CPC、CPO)にまで及びます。各ソリューションは、伝送距離、TCO(総所有コスト)あたりの性能、およびワットあたりの性能が最適化されるよう調整されています。ラックやシステム全体を見据えて設計されたこれらの技術は、汎用品(コモディティ)ではなく、性能要件に合わせて最適化されたカスタム・ソリューションです。
オンパッケージ
ダイ間インターコネクト
技術
UCIe
Mlink
オンボード
チップ間インターコネクト
技術
高速SerDes (PCIe)
ULED
オフボード
基板間インターコネクト
技術
高速SerDes(イーサネット)
NVLink Fusion
NPC/CPCコネクタ
Co-Package Optics(CPO)
スケールアップ
システム間
ラック間
テクノロジー
アクティブ光ケーブル
アクティブ電気ケーブル
コ・パッケージド・オプティクス
高速 SerDes(Ethernet)
データセンターを構成するコア・ビルディング・ブロック
AIコンピュートシステム
「コンピュート」、「スケールアップ」、「スケールアウト・インターコネクト」という3つの柱にわたる協調最適化。
業界標準(UALink、UEC)および独自(NVLink)のインターコネクト・ソリューションに対応。
ヘテロジニアス・インテグレーション(異種機能統合)により、性能とTCOを改善し、新たなシステム用途を実現。
ラック
コンピューティング導入・運用の新たな「最小単位」。
クラウドAIおよびエンタープライズお客様に対し、ハードウェアとソフトウェアの垂直統合によるさらなる価値を提供。
電力、熱設計(排熱)、そして信頼性が、システム全体のパフォーマンスを左右する。
効果的な収益化には、多様な用途に応じたラックの最適化が不可欠です。
クラス最高のデータセンター効率を実現する上で、「性能/TCO」および「性能/ワット」が極めて重要な指標となります。
MediaTekとの提携により
NVIDIA NVLink Fusion
NVLink Fusionエコシステムの主要パートナーとして、MediaTekは包括的なラック・レベル・ソリューションを提供し、お客様の市場投入までの期間短縮を支援します。NVLink C2Cを介してカスタムXPUをNVIDIAエコシステムにシームレスに接続し、ラックレベルのASICコンピュート・トレイとNVSwitchトレイから、InfiniBandやEthernetによるさらなるスケールアウトまで、アーキテクチャ全体を拡張できます。NVIDIAとの強固なパートナーシップを活かし、当社はエンドツーエンドのフルスタック型データセンターソリューションという、希少な包括的ソリューションを提供しており、この革新的な取り組みはすでにお客様から大きな関心を集めています。
次世代アクティブ光ケーブル(AOC)
MicroLED光源とMOSAICアーキテクチャを採用した次世代アクティブ光ケーブル(AOC)。
MediaTekとMicrosoftによる概念実証(PoC)の成果:
- 大幅な消費電力の削減
- AIクラスターにおける伝送距離の拡大
- 銅線(カッパー)と同等の信頼性
- 優れた拡張性
ギガワット級のAIデータセンターに向け、さらなる小型化と量産体制の確立に取り組んでいます。
関連記事
よくある質問
XPUは、大規模なAIモデルの学習や推論(サービング)に伴う膨大な並列演算処理のニーズに対応するために専用設計された、AIアクセラレータの一種です。汎用的な逐次処理に最適化されたCPUや、本来グラフィックス処理用に設計されたGPUとは異なり、XPUはAIワークロードのためにゼロから設計されています。具体的には、テンソル演算、行列演算、スパース(疎行列)演算におけるスループットを最大化するよう最適化されています。現代のAIデータセンターにおいて、XPUはAI演算システムの中核を担います。CPUやDPUと連携するヘテロジニアス(異種混在)アーキテクチャの中で、各プロセッサがAIライフサイクルの各段階において最も効率的な処理を分担する仕組みとなっています。MediaTekは、高度なパッケージング技術、広帯域メモリ(HBM)、インターコネクトと統合的に最適化されたカスタムXPUを設計し、単一のシステムとして提供しています。
AI向けカスタムASIC(特定用途向け集積回路)とは、既製のシリコン製品を利用するのではなく、特定の企業のモデルアーキテクチャ、ワークロード特性、インフラ上の制約に合わせてゼロから設計されたチップのことです。ハイパースケーラーやクラウドサービスプロバイダーがカスタムASICsを開発するのは、アーキテクチャを自社で制御し、ワットあたりの性能やTCO(総所有コスト)あたりの性能を最適化するとともに、汎用ハードウェアに伴う非効率性を回避するためです。MediaTekはこうした顧客と連携し、ロジックダイの設計やメモリインターフェースのアーキテクチャから、最先端の2.5D/3.5Dパッケージング、ラックレベルの統合に至るまで、カスタムASICsやXPUの設計・開発をエンドツーエンドで支援しています。その結果生み出されるのは、大規模運用時における「ワットあたりのトークン数」や「コストあたりのトークン数」といった重要な指標において、汎用的なソリューションを凌駕する、特定のワークロードに最適化されたコンピュートエンジンです。
AIコンピュートシステムとは、大規模なAIモデルの学習や、膨大な量のAI推論を大規模に実行するための包括的なハードウェアスタックであり、単なる単一のチップの枠をはるかに超えるものです。その中核となるのはXPU(AIアクセラレータ)ですが、その周囲には完全なファブリックが構築されています。これには、異なるワークロードのフェーズに合わせて最適化されたヘテロジニアス・コンピュート(CPU、DPU、XPU)、高い帯域幅とビットあたりの低消費電力を維持するスケールアップ・インターコネクト(オンパッケージのダイ間リンク)、そして帯域幅・到達距離・効率を重視して構築されたスケールアウト・インターコネクト(ラックおよびデータセンターレベルのファブリック)が含まれます。また、データ移動に伴うエネルギー消費を抑えるため、HBM、cHBM、LPDDR、SRAMといったメモリがコンピュート機能と同一パッケージ内に統合されています。さらに、高度なパッケージング技術(2.5D、3.5D、ウェーハレベル)を用いることで、これら多種多様なコンポーネントが統合され、一つの有機的なエンジンとして機能します。MediaTekは、すべての要素が相互に最適化されたAIコンピュートシステムを設計しており、ラックを単なる部品の集合体ではなく、戦略的な資産へと変革しています。
CPOは、光トランシーバーを別のラインカードに配置するのではなく、光エンジンをチップパッケージ内(通常は演算用ダイや広帯域メモリと同じシリコンインターポーザまたは基板上)に直接統合する技術です。ラックや列(ロウ)間で膨大なデータを低遅延かつ低消費電力で転送するスケールアウト・ネットワーキングが求められるAIデータセンターにおいて、CPOは従来のプラグイン型光モジュールと比較して、ビットあたりのエネルギー消費と信号損失を劇的に低減します。AIクラスターの規模が数百から数万のXPUへと拡大するにつれ、インターコネクトの消費電力と帯域幅密度が最優先の制約事項となりますが、その有力な解決策としてCPOが台頭しています。MediaTekは、顧客ごとのI/Oおよびシステムレベルの接続要件に応じて、インターポーザベースや標準的なパッケージング手法を用い、同社のAI演算システム設計にCPOを組み込んでいます。
2.5Dや3.5Dといったアドバンスド・パッケージング技術を活用することで、AIチップの設計者は単一ダイ(半導体チップ)が抱える物理的な制約を克服できます。具体的には、演算用ダイ、メモリインターフェース用ダイ、HBMスタック、SerDes、光エンジンなどの複数のチップレットを1つのパッケージに統合し、それらを単一のシステムとして機能させることが可能になります。2.5Dパッケージングでは、各コンポーネントをシリコンインターポーザ上に並べて配置することで、パッケージ内部で極めて高いメモリ帯域幅を実現します。一方、3.5Dや3Dの統合技術では垂直方向の積層を取り入れ、ロジックとメモリ間の結合を強化することで、レイテンシの低減と消費電力の抑制を図ります。これはAIワークロードにおいて極めて重要です。多くの場合、メモリ帯域幅が最大のボトルネックとなりますが、アドバンスド・パッケージングを用いれば、モノリシック(単一)ダイでは実現不可能なレベルの帯域幅密度を達成できるからです。MediaTekは、同社のAI演算システム全体にDTCO(設計・技術の協調最適化)およびSTCO(システム・技術の協調最適化)を適用しています。その目標は、システムレベルでのワット当たり性能を100倍に向上させるとともに、レチクル(露光用マスク)サイズの制約を超えて、実質的に40倍のシステム規模を実現することにあります。
AIモデルのトレーニングとは、大規模なデータセットを用いて、大規模な言語モデルやマルチモーダルモデルを学習させる、計算負荷の高いプロセスです。そのため、極めて高いメモリ帯域幅、高い持続的なスループット、そして長時間の処理に耐える能力が求められます。一方、AI推論とは、学習済みのモデルをリアルタイムの予測、意思決定、あるいは生成出力に大規模に展開するプロセスです。ここでは、低レイテンシ、高並列処理、そしてエネルギー効率が最優先事項となります。最新のAIデータセンターでは、これらのワークロードを両方実行しており、多くの場合、それぞれのフェーズに最適化された異なるハードウェア上で動作します。XPUはトレーニングの高スループット要求に合わせて調整され、DPUはネットワークとストレージのオフロードを管理し、CPUはオーケストレーションと制御プレーンのタスクを処理します。MediaTekは、トレーニングと推論の両方に対応するようメモリ階層、相互接続、パッケージングを最適化した、異種混在型のAIコンピューティングシステムを設計しています。これには、推論のプリフィル段階とデコード段階に対応した、差別化されたアーキテクチャも含まれます。
TOPS(Tera Operations Per Second:1秒あたりのテラ演算数)は理論上の最大処理能力を測定するものですが、消費電力、メモリ帯域幅の制約、実際のワークロードにおける効率などを考慮していません。そのため、AIデータセンターの実際の経済性を評価する指標としては不十分です。一方、「ワットあたりのトークン数」は、消費電力1ワットあたりにシステムがどれだけの有用なAI出力(生成されたトークンや提供された予測結果など)を生み出せるかを測定するものであり、運用コストや施設の処理能力に直結します。世界的にデータセンターの消費電力が増大し、ハイパースケーラー(大規模クラウド事業者)が電力網の供給能力の限界に直面する中、「ワットあたりのトークン数」は、AIアクセラレータやカスタムASICsを評価する上で決定的なベンチマークとなっています。MediaTekは、ラックレベルでの「ワットあたりのトークン数」を最大化するため、低電圧回路設計や「インメモリ・コンピューティング(CiM)」アーキテクチャから、コパッケージド・オプティクス(CPO)、システムレベルの電力供給に至るまで、カスタムXPUやAI演算システムの設計全体において、エネルギー効率を最優先の設計制約事項として位置づけています。
HBM(High Bandwidth Memory)は、大規模なAIモデルの学習や推論に求められる極めて高いメモリ帯域幅を実現するために、AIアクセラレータやカスタムASICと同一パッケージ内に統合(コパッケージ)される積層型DRAMです。モデルの規模が数十億から数兆パラメータへと拡大するにつれ、演算スループットとメモリ帯域幅の間のギャップ、いわゆる「メモリの壁(memory wall)」が、AIシステムにおける性能上の最大の制約要因となっています。HBMは、高度な2.5D/3Dパッケージング技術を用いて、広帯域インターフェースを備えたメモリダイを演算ダイの直上または隣接する位置に配置することでこの課題を解決し、パッケージあたり毎秒数テラバイトという帯域幅を実現しています。MediaTekは、演算ダイとHBMやその他のメモリ技術(cHBM、LPDDR、SRAMなど)を接続する専用のメモリインターフェースダイを設計し、各ワークロードの特性に合わせて帯域幅、容量、レイテンシを最適化しています。さらに今後は、HBF(High Bandwidth Flash)のような新たな技術の設計も進められており、これによって、かつてない大容量メモリを活用した大規模な推論の実現が期待されています。
既製のAIチップは、多種多様なワークロードを抱える多くの顧客に対応するために設計された汎用アクセラレータです。これらは特定のモデルアーキテクチャ、システム規模、インフラの制約に合わせて最適化されているわけではなく、あくまで「平均的な」ユースケース向けに最適化されています。一方、MediaTekのエンドツーエンド・アプローチでは、カスタムASICやXPU、高度なパッケージング(2.5D/3.5D)、メモリ階層、高速インターコネクト、コパッケージ・オプティクス、電力供給、ラック統合といった要素を、単一のAIコンピュート・システムとして共同設計します。これらすべてが、顧客固有のモデル、電力予算、TCO(総所有コスト)目標に合わせて最適化されるのです。このような垂直統合により、顧客は汎用的なソリューションと比較して優れた「TCOあたりの性能」や「ワットあたりの性能」を実現できるだけでなく、独自のプラットフォーム・アーキテクチャを保有することで、長期的な競争優位性を確保できます。MediaTekは、大規模なモデルの学習や推論(サービング)のあり方に長期的な投資を行っているハイパースケーラー、クラウドサービスプロバイダー、AIプラットフォーム企業とパートナーシップを組んでいます。
AIインフラ向けのカスタムシリコンとは、汎用的な市販製品を購入するのではなく、特定の企業のAIワークロードに合わせて独自に設計されたチップやシステムを指します。その範囲は、カスタムASIC(特定用途向け集積回路)やカスタムXPU(アクセラレータ・プロセッサ)から、メモリインターフェース・ダイ、SerDesチップレット、光統合技術に至るまで多岐にわたり、これらが統合されて完全なAI演算システムとして構築されます。Google、Meta、Amazon、Microsoftといったハイパースケーラーがこのトレンドを主導し、数百万基のGPUに匹敵する規模での学習や推論を最適化するためにカスタムシリコンを開発してきました。現在では、エンタープライズ向けクラウドプロバイダーやAIネイティブ企業もこれに追随する動きを強めています。その原動力となっているのは経済性です。特定のモデルクラスや導入環境に合わせて設計されたカスタムシリコンは、既製品(オフ・ザ・シェルフ製品)と比較して、ワットあたりの性能やTCO(総所有コスト)あたりの性能において2〜5倍の効率を実現できるからです。MediaTekは、主要なファウンドリと提携し、ロジックダイのアーキテクチャから、高度なパッケージング、インターコネクト、ラックへの統合に至るまで、カスタムシリコン・ソリューションをエンドツーエンドで設計・提供しています。