專為驅動次世代 AI 應用場景而設計,專用運算晶粒能夠提供大規模平行處理密度,以加速複雜的 AI 訓練與大規模低延遲推論工作負載。
深入了解如何最大化製程紅利以提升效能功耗比 (Perf/Watt)
率先採用先進製程
聯發科技處於製程技術的最前沿,已在 N3 製程完成 10 次以上流片,在 N2 製程完成 2 次以上流片,首款 A14 測試晶片也將於今年度完成流片。
我們以行動業務為先導 — 憑藉龐大的出貨量與規模優勢實現良率優化與製程技術協同最佳化 (DTCO),並將這些經驗迅速應用於大規模資料中心設計。此項模式使我們能夠比業界任何競爭對手都更快將資料中心晶片推進至先進製程節點。
設計-技術協同最佳化 (DTCO)
透過 DTCO,我們與領先晶圓廠的最先進 (SOTA) 製程節點直接合作,對製程進行微調,並客製化、最佳化電晶體。
透過設計-技術協同最佳化 (DTCO),我們與領先晶圓廠的最先進 (SOTA) 製程節點直接合作,對製程進行微調,並客製化、最佳化電晶體 — 充分發揮矽晶所能提供的每一分效能。
無論是建構設計單一 ASIC,還是打造完全異質化的 XPU,我們都能協助客戶充分釋放製程的全部潛力,將其轉化為決定性的競爭優勢。
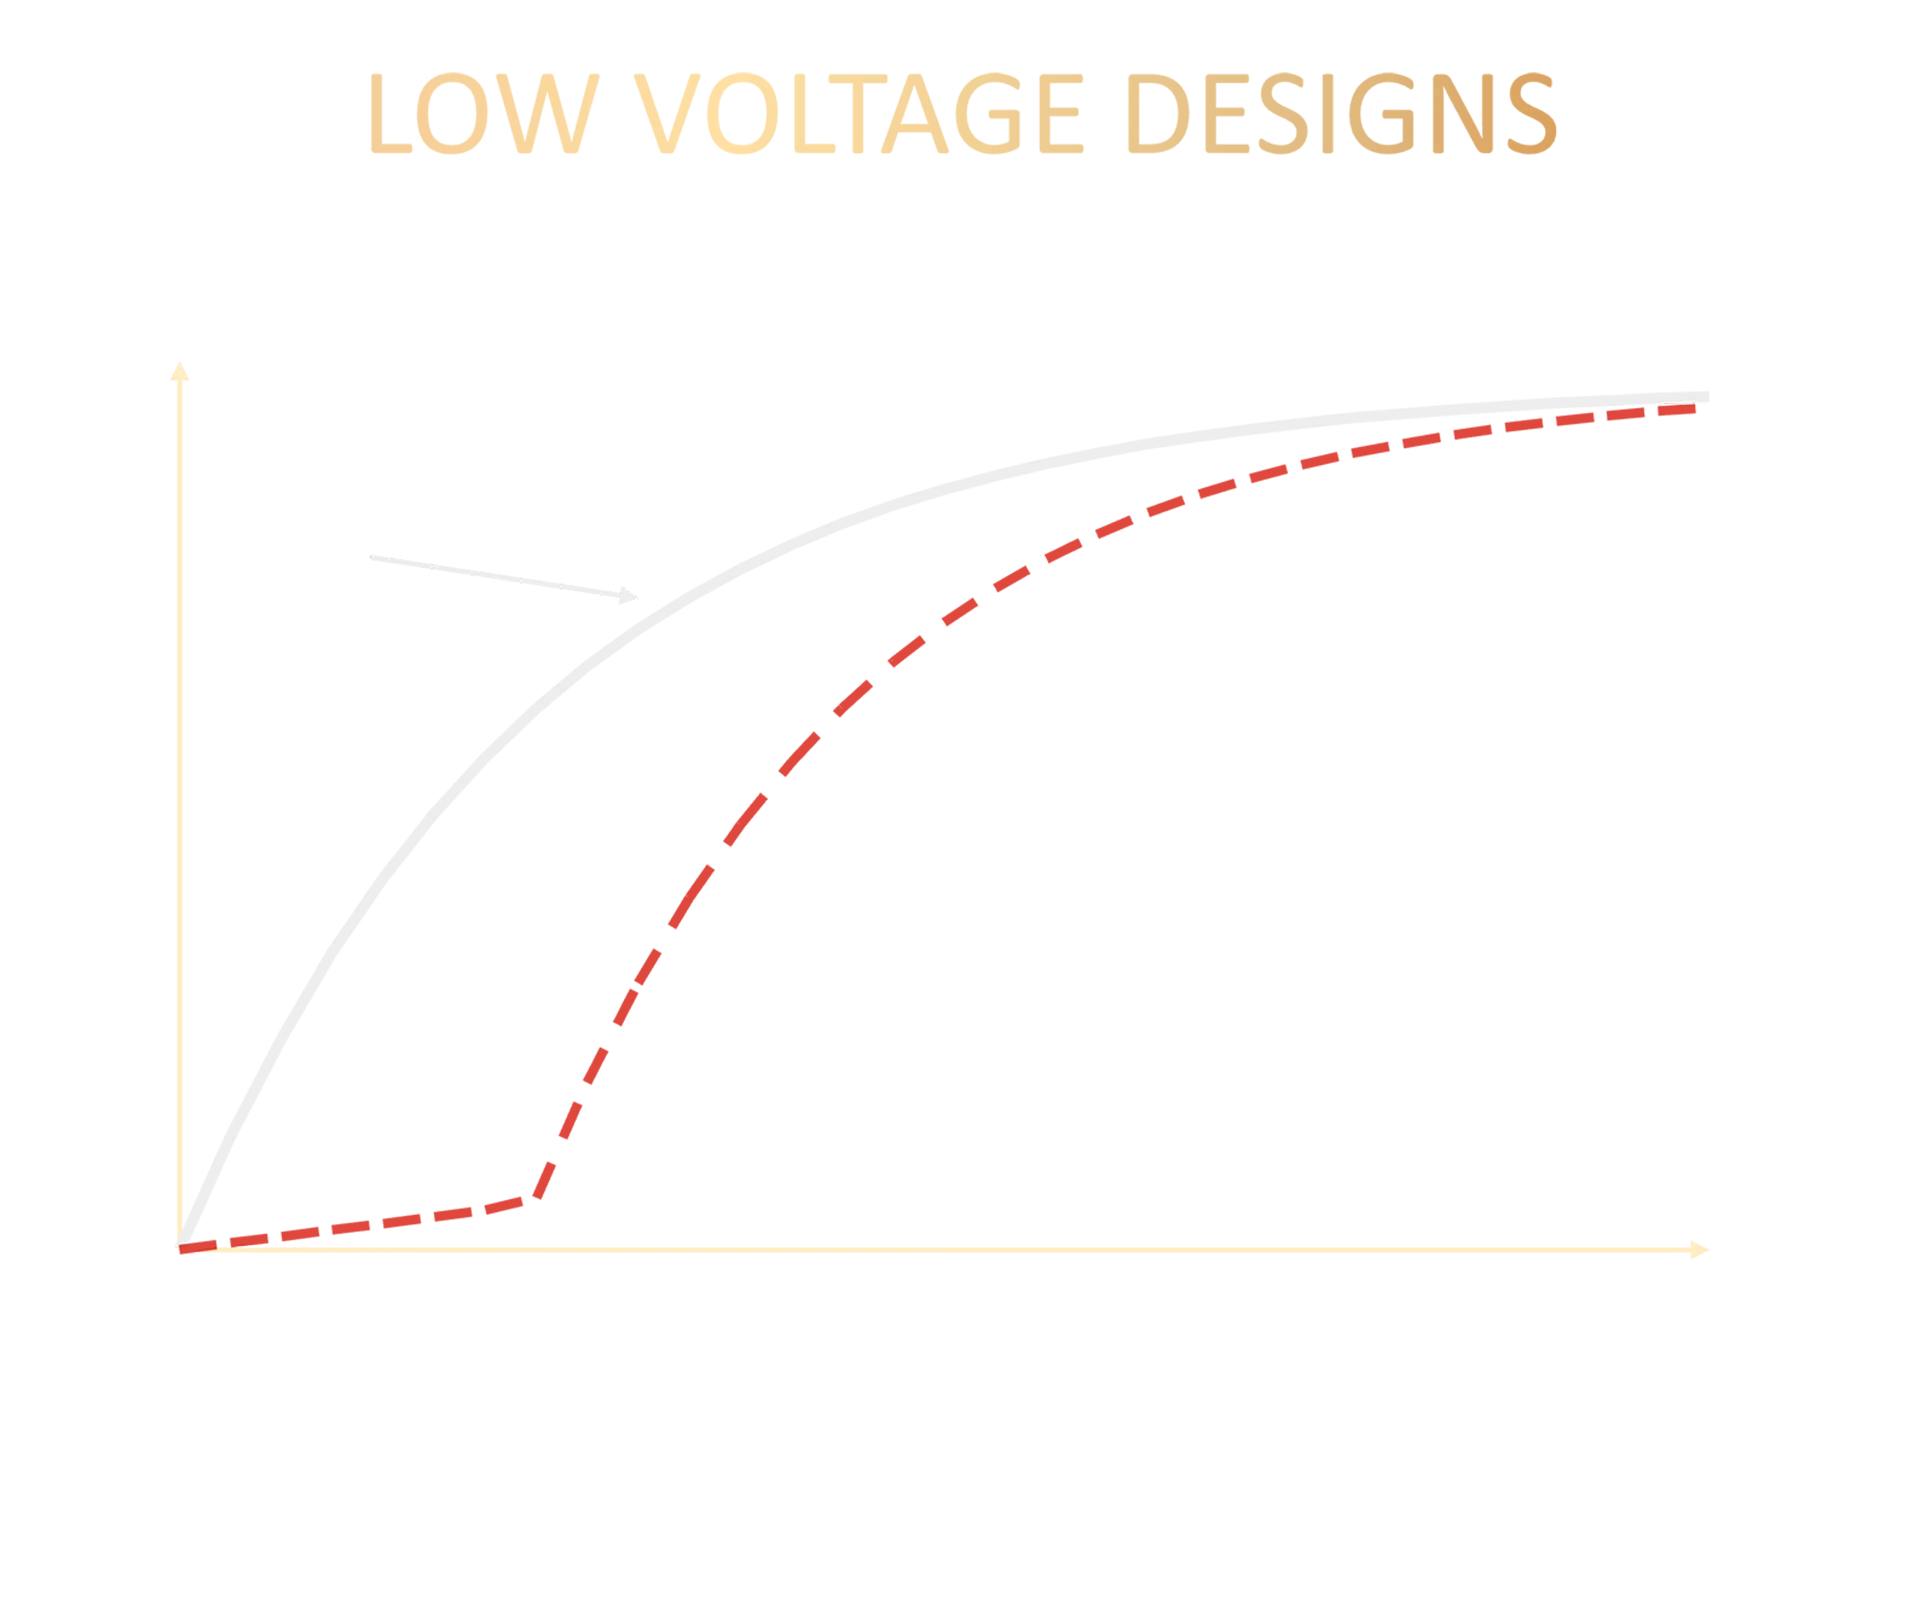
透過降壓運作提升運算效率
聯發科技豐富的行動業務經驗,可進一步應用於資料中心晶片,擁有顯著的先發優勢。
有效提升運算效率的方式,就是讓晶片在更低電壓下運作。由於功耗與電壓呈三次方關係,降低電壓所帶來的影響會被顯著放大 — 在當今資料中心功耗預算固定的前提下,至關重要。真正的挑戰並非單純降低運作電壓,而是要移動效能曲線的拐點,確保降壓時效能不會呈非線性驟降。這需要在設計、製程技術與電路架構層面進行深度協同最佳化。聯發科技豐富的行動業務經驗 — 低電壓運作正是其立身之本 — 可進一步將這些經驗應用於資料中心晶片,擁有顯著的先發優勢。
打造 XPU 的核心元件
每一顆 XPU 都始於同一個步驟:從一片晶圓開始,並進行極為精密的切割。晶圓切割 (die singulation) 會將一片晶圓分割成數百顆相同的晶粒,而這些晶粒正是最終組裝成完整晶片的基本單元。
每一座 AI 資料中心,都從這裡開始
客製化 ASIC — 由聯發科技設計
多片晶圓,各自承擔不同功能
AI 運算、記憶體介面與互連,從獨立晶圓上的功能單元,走向完整的資料中心解決方案
晶圓切割
用於先進封裝的客製化 ASIC 晶粒
運算晶粒
專為 AI 時代打造,針對特定應用進行設計與最佳化
先進封裝。
運算。記憶體。I/O。
整合為一個統一的 AI 算力引擎,為高頻寬而生,為規模化而生
先進封裝
封裝已不再是設計的最後一步。要滿足當今 AI 系統對效能與能效的要求,先進封裝本身就是關鍵。
矽與封裝的協同設計,是現代 AI 系統架構不可或缺的一環。它讓我們突破單一晶粒設計的限制,將異質元件整合為一個高度協同、統一運作的運算引擎。
先進封裝
2.5D
透過 2.5D 封裝,將運算單元 (compute tile) 與 HBM 並排配置於各類矽中介層 (silicon interposer) 上,從單一封裝中實現強大的運算效能。
規格: <10,000 平方毫米矽晶面積
先進封裝
3.5D
3.5D 與 3D 式整合技術引入垂直晶粒堆疊及更為複雜的整合方式,最大程度縮短邏輯、記憶體與 I/O 之間的距離,降低資料搬移成本。
與此同時,異質整合成為推動進步的關鍵方向。我們以奈米級精度,將 CPU、XPU、高頻寬記憶體、高速 I/O 晶粒,乃至電源與散熱結構整合在一起。
規格: 10,000 至 20,000 平方毫米矽晶面積
XPU
聯發科技從零開始為其客戶架構設計運算需求,客戶也可以提供自有的 AI 加速器/邏輯 IP 與微架構,由我們將其整合為一個協同運作的系統。
運算晶粒
專為驅動次世代 AI 應用場景而設計,專用運算晶粒能夠提供大規模平行處理密度,以加速複雜的 AI 訓練與大規模低延遲推論工作負載。
記憶體介面晶粒
我們專門設計的記憶體介面晶粒可連接 HBM 及其他先進記憶體技術,並能靈活滿足不同的頻寬、容量與延遲要求,從而針對不同 AI 模型類型與部署情境進行精準最佳化。
記憶體
記憶體是 AI 系統物料清單成本和功耗的主要來源,如何實現最佳性價比是最大的挑戰。實現規模化意味著需要在容量、頻寬和成本之間取得平衡,同時考量供應鏈的實際限制。聯發科技率先將Digital Compute-in-Memory (DCIM) 技術運用於邊緣 NPU,直接在記憶體陣列執行運算,從而減少頻寬瓶頸。
超高速 I/O
我們整合超高速 I/O 與互連晶粒,並採用共封裝銅互連 (CPC) 等創新技術,為短距離、高頻寬通道提供高效連接。
針對長距離連接,光引擎 (OE) 代表下一階段的技術前沿,並推動向共封裝光學 (CPO) 演進。光引擎既可採用標準封裝技術進行整合,也可結合先進的中介層方案,以進一步提升整合密度。
系統-技術協同最佳化 (STCO)
在設計-技術協同最佳化 (DTCO) 的基礎上,還需要系統-技術協同最佳化 (STCO) 才能實現晶片設計的全面最佳化。藉助 CoWoS 級與 EMIB 級等先進平台,實現效能、密度、功耗與成本之間的最佳平衡。
XPU
聯發科技從零開始為其客戶架構設計運算需求,客戶也可以提供自有的 AI 加速器/邏輯 IP 與微架構,由我們將其整合為一個協同運作的系統。
我們專門設計的記憶體介面晶粒可連接 HBM 及其他先進記憶體技術,並能靈活滿足不同的頻寬、容量與延遲要求,從而針對不同 AI 模型類型與部署情境進行精準最佳化。
記憶體是 AI 系統物料清單成本和功耗的主要來源,如何實現最佳性價比是最大的挑戰。實現規模化意味著需要在容量、頻寬和成本之間取得平衡,同時考量供應鏈的實際限制。聯發科技率先將Digital Compute-in-Memory (DCIM) 技術運用於邊緣 NPU,直接在記憶體陣列執行運算,從而減少頻寬瓶頸。
我們整合超高速 I/O 與互連晶粒,並採用共封裝銅互連 (CPC) 等創新技術,為短距離、高頻寬通道提供高效連接。
針對長距離連接,光引擎 (OE) 代表下一階段的技術前沿,並推動向共封裝光學 (CPO) 演進。光引擎既可採用標準封裝技術進行整合,也可結合先進的中介層方案,以進一步提升整合密度。
在設計-技術協同最佳化 (DTCO) 的基礎上,還需要系統-技術協同最佳化 (STCO) 才能實現晶片設計的全面最佳化。藉助 CoWoS 級與 EMIB 級等先進平台,實現效能、密度、功耗與成本之間的最佳平衡。
業界領先的互連技術
聯發科技提供完整層級的專有互連解決方案 — 從封裝內晶粒間互連 (UCIe、MLink),到板上晶片間互連(SerDes/PCIe、uLED),再到長距離電氣與光學互連(SerDes/乙太網路、NPC/CPC、CPO) — 每一層級均針對最佳傳輸距離、單位 TCO 效能與單位功耗效能進行調校。這些方案充分考量機架與系統整體需求,實現的是可擴展的客製化效能,而非通用商品化方案。
封裝內
晶粒間互連
技術
UCIe
Mlink
板上
晶片間互連
技術
高速 SerDes (PCIe)
uLED
板外
板間互連
技術
高速 SerDes(乙太網路)
NVLink Fusion
NPC/CPC 連接器
共封裝光學
擴展
系統到系統
機架到機架
技術
主動式光纜
主動式電纜
共封裝光學
高速 SerDes(乙太網路)
資料中心的核心建構元件
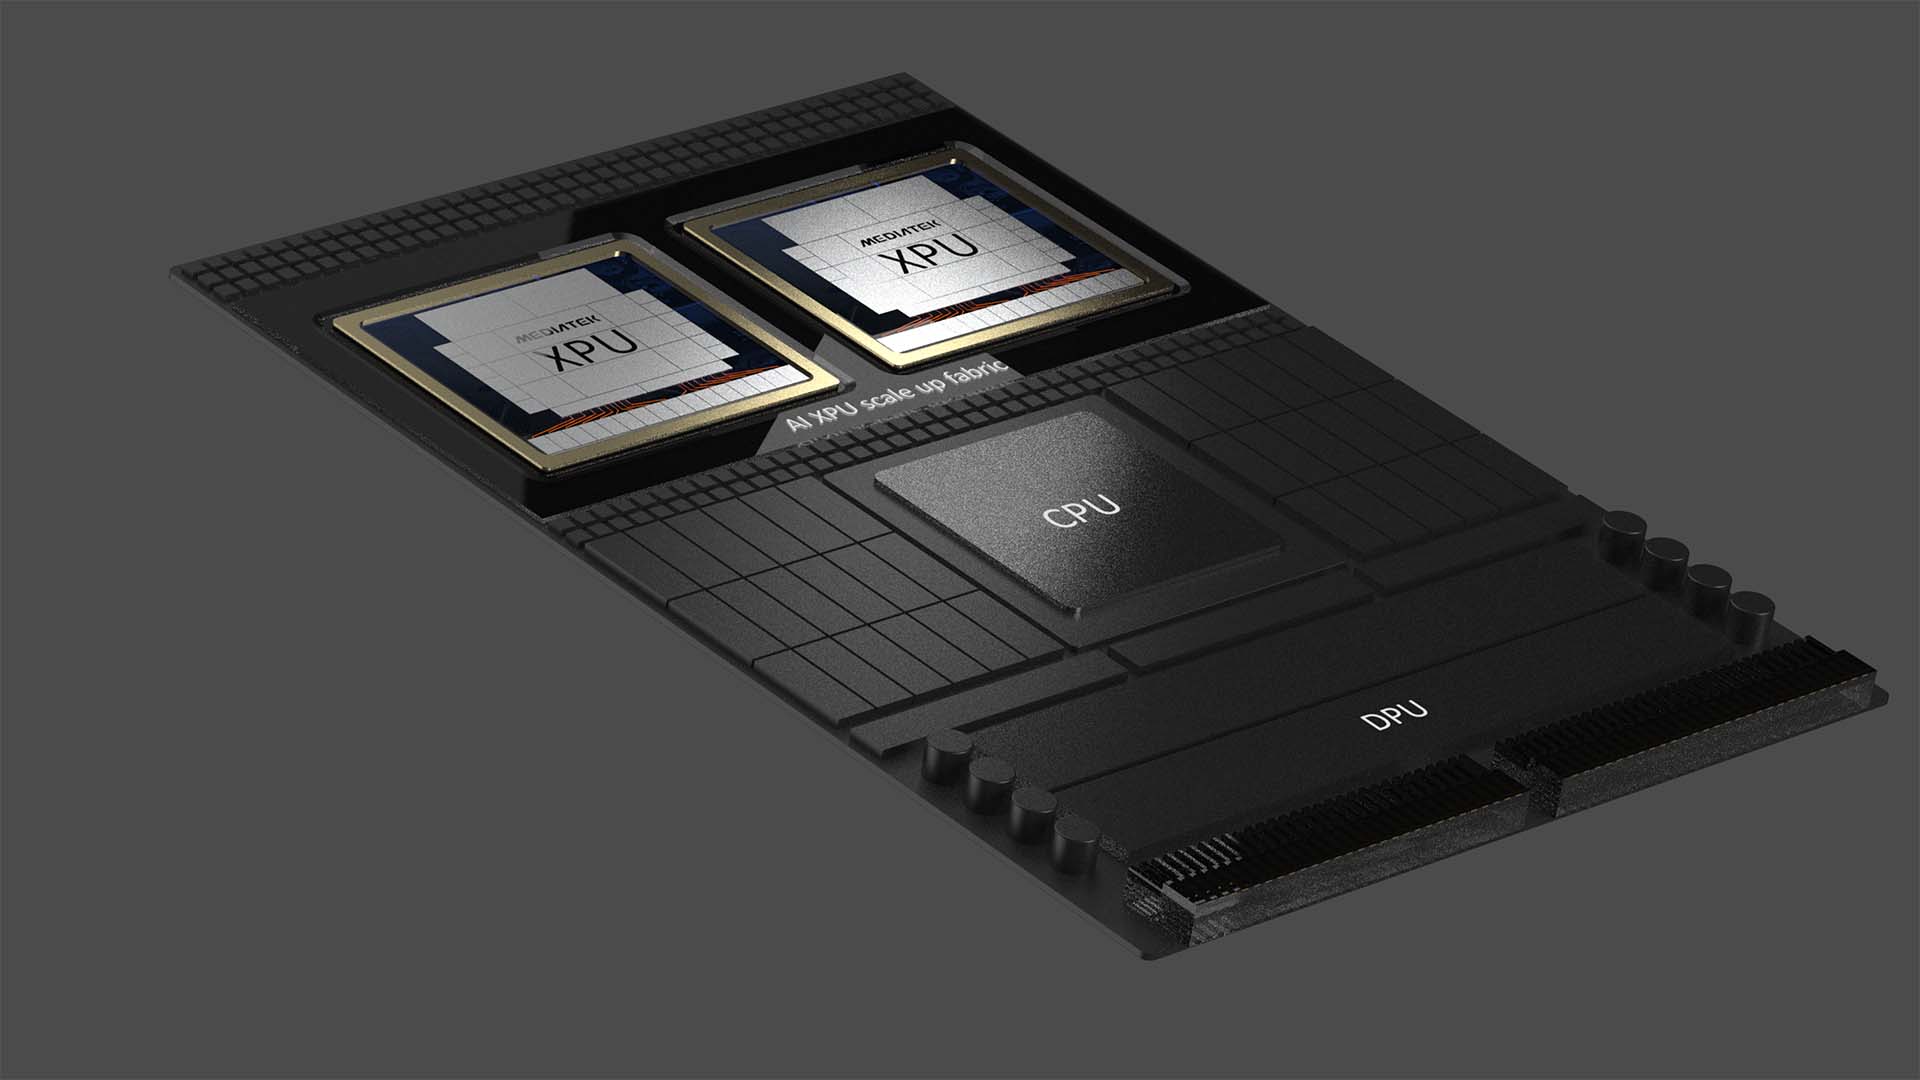
AI 運算系統
圍繞三大支柱進行協同最佳化: 運算、垂直擴展 (Scale-up) 互連與水平擴展 (Scale-out) 互連
支援業界標準互連方案 (UALink、UEC) 以及專有互連方案 (NVLink)
透過異質整合,支援新的系統應用場景,並提升效能/TCO 表現
機架
新的運算消費單位
透過面向雲端 AI 與企業客戶的軟硬體垂直整合,創造更高價值。
功耗、散熱與可靠性決定了效能表現。
要實現有效的商業變現,需要針對不同使用場景對機架進行最佳化。
單位 TCO 效能與單位功耗效能是實現頂級資料中心能效的關鍵指標。
與 聯發科技 合作
NVIDIA NVLink Fusion
作為 NVLink Fusion 生態系統的關鍵參與者,聯發科技以完整的機架級解決方案,協助客戶加快產品上市進程。透過 NVLink C2C 將客製化 XPU 無縫連接至 NVIDIA 生態系統,我們的架構從機架級 ASIC 運算托盤與 NVSwitch 托盤延伸,並可進一步透過 InfiniBand 與 Ethernet 實現橫向擴展。憑藉與 NVIDIA 的強大合作夥伴關係,我們提供從端到端的完整全棧資料中心解決方案,這項創新方案已引起客戶的濃厚興趣。
新一代主動光纜 (AOC)
新一代主動光纜 (AOC),採用 MicroLED 光源與 MOSAIC 架構
聯發科技與微軟的概念驗證成果展示:
- 顯著節能
- 延長 AI 叢集的傳輸距離
- 達到銅纜等級的可靠性
- 更強的可擴充性
我們致力於進一步實現小型化,並為吉瓦級 AI 資料中心做好量產準備
相關文章
常見問題
XPU 是一類專為因應大型 AI 模型訓練與推論所需的大規模平行運算需求而設計的 AI 加速器。與專為通用序列任務最佳化的 CPU、或最初為圖形處理而設計的 GPU 不同,XPU 從設計之初就專為 AI 工作負載而生 — 旨在最大化張量運算、矩陣運算與稀疏運算的吞吐量。在現代 AI 資料中心中,XPU 處於 AI 運算系統的核心位置,與 CPU、DPU 共同構成異質架構,由每種處理器負責其運作效率最高的 AI 生命週期階段。聯發科技設計的客製化 XPU,將先進封裝、高頻寬記憶體 (HBM) 與互連技術作為一個統一系統進行協同最佳化。
面向 AI 的客製化 ASIC(特殊應用積體電路) 是一種從零開始設計的晶片,專門匹配特定企業的模型架構、工作負載特性與基礎設施限制條件,而非依賴現成的通用晶片。超大規模雲端服務商與雲端服務供應商打造客製化 ASIC,是為了掌握架構主導權、最佳化單位功耗效能與單位 TCO 效能,並避免通用硬體帶來的低效問題。聯發科技與這些客戶展開端到端合作,共同架構設計客製化 ASIC 與 XPU: 從邏輯晶粒設計、記憶體介面架構,到先進的 2.5D/3.5D 封裝與機架級整合,全流程涵蓋。最終成果是一套專為特定工作負載打造的運算引擎,在真正重要的指標 — 大規模場景下的單位功耗 Token 數與單位成本 Token 數 — 上超越通用商品化方案。
AI 運算系統是訓練大型 AI 模型並大規模執行高吞吐量 AI 推論所需的完整硬體堆疊 — 其範疇遠超單一晶片。其核心是 XPU(AI 加速器),但圍繞它還有一整套完整架構: 異質運算(針對不同工作負載階段調校的 CPU、DPU 與 XPU)、垂直擴展互連(維持高頻寬、低單位位元能耗的封裝內晶粒間互連),以及水平擴展互連(為頻寬、傳輸距離與效率而打造的機架級與資料中心級架構)。記憶體 — HBM、cHBM、LPDDR、SRAM — 與運算單元共同封裝,以降低資料搬移所消耗的能量。先進封裝(2.5D、3.5D、晶圓級) 將這些異質元件整合為一個協同運作的整體。聯發科技設計的 AI 運算系統對每一環節都進行協同最佳化,使機架成為一項策略性資產,而非零組件的簡單堆砌。
共封裝光學 (CPO) 是一種將光引擎直接整合進晶片封裝內的技術 — 通常與運算晶粒、高頻寬記憶體共用同一矽中介層或基板,而非將光收發模組置於獨立的線卡上。在 AI 資料中心中,水平擴展網路必須以低延遲、低功耗在機架與機架列之間傳輸海量資料,相較於傳統可插拔光模組,共封裝光學能夠大幅降低單位位元能耗與訊號損耗。隨著AI叢集規模從數百個 XPU 擴展至數萬個 XPU,互連功耗與頻寬密度已成為首要制約因素,而 CPO 正逐漸成為主流解決方案。聯發科技會根據每位客戶的 I/O 與系統級連接需求,採用基於中介層或標準封裝的方式,將共封裝光學整合進其 AI 運算系統設計中。
先進封裝 — 包括 2.5D 與 3.5D 整合技術 — 使 AI 晶片設計者能夠突破單一晶粒的物理限制,將多個晶粒(運算晶粒、記憶體介面晶粒、HBM 堆疊、SerDes、光引擎) 整合進一個如同統一系統般運作的封裝中。在 2.5D 封裝中,各元件並排配置於矽中介層上,在封裝內部實現極高的記憶體頻寬。3.5D 與 3D 整合則加入了垂直堆疊,使邏輯與記憶體之間的耦合更加緊密,從而降低延遲與功耗。對 AI 工作負載而言,這一點至關重要: 記憶體頻寬往往是主要瓶頸,而先進封裝能夠實現單一晶粒無法企及的頻寬密度。聯發科技在其AI運算系統中全面應用設計-技術協同最佳化 (DTCO) 與系統-技術協同最佳化 (STCO),目標是將系統級單位功耗效能提升 100 倍,並將等效光罩系統尺寸有效提 有效提升 40 倍。
AI 模型訓練是在海量資料集上教會大型語言模型或多模態模型的高運算密集型過程 — 它對記憶體頻寬、持續高吞吐量以及長時間作業的容忍度都有極高要求。AI 推論則是將訓練完成的模型部署投入使用,以大規模提供即時預測、決策或生成式輸出——它更看重低延遲、高並發與能效表現。現代 AI 資料中心會同時執行這兩種工作負載,通常針對各階段採用不同的最佳化硬體。XPU 專為訓練所需的高吞吐量而調校; DPU 負責網路與儲存卸載管理; CPU 則處理協調與控制平面任務。聯發科技設計的異質 AI 運算系統,針對訓練與推論兩個場景對記憶體層級架構、互連與封裝進行協同最佳化,並針對推論中的預填充 (prefill) 與解碼 (decode) 階段採用差異化架構設計。
TOPS(每秒兆兆次運算) 衡量的是理論峰值吞吐量,但它忽略了功耗、記憶體頻寬限制以及實際工作負載效率——因此難以準確反映 AI 資料中心的真實營運經濟性。每瓦 Token 數衡量的是系統每消耗一瓦功率所能產出的有效 AI 輸出量(產生的 Token 數、提供的預測結果數),這項指標與營運成本及機房容量直接掛鉤。隨著全球資料中心功耗持續攀升、超大規模雲端服務商逐漸觸及電網供電上限,每瓦 Token 數已成為評估 AI 加速器與客製化 ASIC 的核心基準指標。聯發科技在其客製化 XPU 與 AI 運算系統設計中,始終將能耗視為首要設計限制 — 從低電壓電路設計、記憶體內運算架構,到共封裝光學與系統級供電方案 — 力求在機架層級實現每瓦 Token 數的最大化。
高頻寬記憶體 (HBM) 是與 AI 加速器及客製化 ASIC 共同封裝的堆疊式 DRAM,用於提供大型 AI 模型訓練與推論所需的極高記憶體頻寬。隨著模型規模從數十億參數成長至數兆參數,「記憶體牆」——即運算吞吐量與記憶體頻寬之間的差距 — 已成為 AI 系統中的主要效能瓶頸。HBM 透過先進的 2.5D/3D 封裝技術,將寬介面記憶體晶粒直接置於運算晶粒之上或旁側,從而在單一封裝內實現每秒數 TB 的頻寬。聯發科技設計專用的記憶體介面晶粒,將運算晶粒與 HBM 及其他記憶體技術 (cHBM、LPDDR、SRAM) 相連,並針對每一類工作負載對頻寬、容量與延遲進行協同最佳化。展望未來,諸如 HBF(高頻寬快閃記憶體) 等新興技術正在研發中,以支援前所未有的記憶體容量,實現大規模推論。
現成的通用 AI 晶片屬於通用型加速器,旨在服務眾多客戶、涵蓋多樣化的工作負載 — 它們是針對中等水平的通用使用場景進行最佳化的,而非專門針對您特定的模型架構、部署規模或基礎設施限制。聯發科技的端到端方案則意味著將客製化 ASIC 或 XPU、先進封裝 (2.5D/3.5D)、記憶體層級架構、高速互連、共封裝光學、供電方案與機架整合,作為一統一的 AI 運算系統進行協同設計 — 所有環節均針對客戶特定的模型、功耗預算與 TCO 目標量身打造。這種垂直整合模式,使聯發科技客戶相較於通用商品化方案,能夠實現更優的單位 TCO 效能與單位功耗效能,同時掌握自有平台架構,從而獲得長期競爭優勢。聯發科技與正在就如何大規模訓練與部署模型進行長期布局的超大規模雲端服務商、雲端服務供應商及 AI 平台企業展開合作。
面向 AI 基礎設施的客製化晶片,是指專為特定企業自身 AI 工作負載而設計的晶片與系統,而非作為標準商用產品購入。其範疇涵蓋客製化 ASIC (特殊應用積體電路)、客製化 XPU (加速處理器)、記憶體介面晶粒、SerDes 晶粒以及光學整合方案 — 所有這些均被整合架構為一套完整的 AI 運算系統。以 Google、Meta、Amazon、Microsoft 為代表的超大規模雲端服務商引領了這股趨勢,他們打造客製化晶片,以在相當於數百萬顆 GPU 的運算規模下最佳化訓練與推論。企業級雲端服務供應商及 AI 原生企業也正日益跟進。這股趨勢背後的驅動力在於經濟性:當針對特定模型類別與部署環境進行設計時,客製化晶片相較於現成方案,能夠實現 2 至 5 倍的單位功耗效能與單位 TCO 效能提升。聯發科技與領先晶圓廠合作,端到端設計並交付客製化晶片解決方案 — 涵蓋邏輯晶粒架構、先進封裝、互連與機架整合等全流程。